

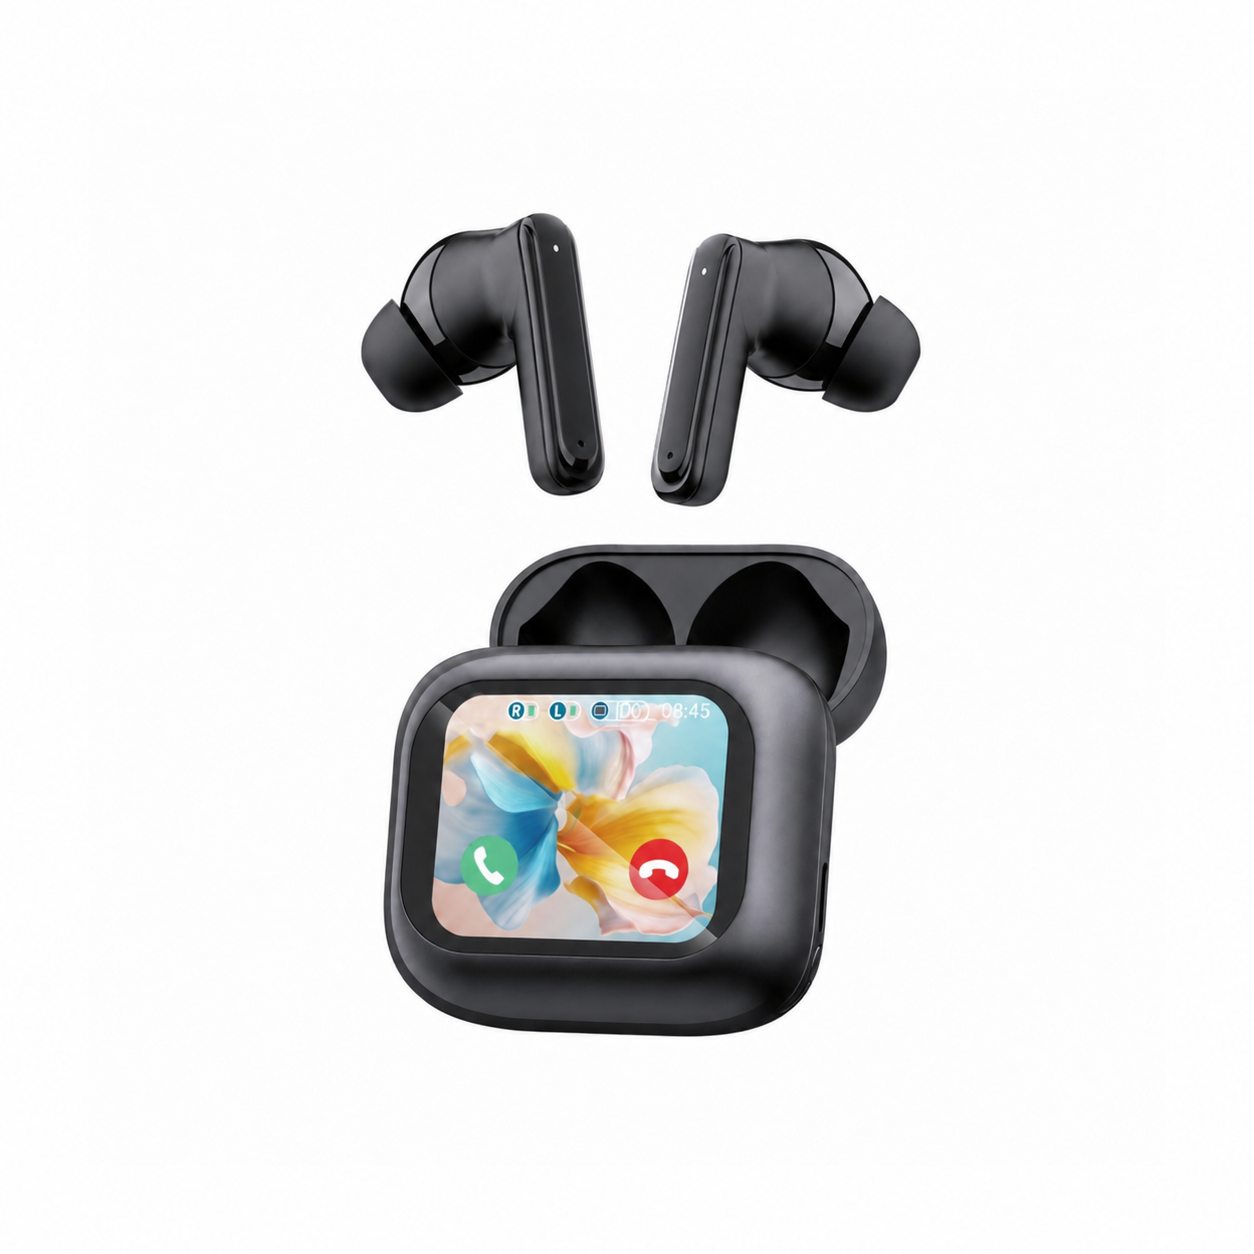
سماعات الترجمة الفورية وزمن استجابة توقف ASR عند نهايات الجمل في المحادثات الحية
غالبًا ما توحي العروض التسويقية لسماعات الترجمة الفورية بدبلجة صوتية لحظية، إلا أن أي شخص يجربها في محطة طوكيو الصاخبة أو جناح تجاري في ميلانو يلاحظ فجوة تتراوح بين ثانيتين وأربع ثوانٍ قبل سماع الصوت المترجم في الأذن. لا ينجم هذا التأخير عادةً عن بطء إرسال البلوتوث أو تباطؤ الخوادم السحابية، بل يعود العائق الأساسي إلى كشف الحدود اللغوية والصوتية داخل محرك التعرف التلقائي على الكلام (ASR).
قبل أن يتمكن نموذج الترجمة الآلية العصبية من تحويل جملة منطوقة بين لغات ذات ترتيب كلمات متعاكس—مثل اليابانية التي تتبع ترتيب «فاعل-مفعول-فعل» إلى الإنجليزية التي تتبع «فاعل-فعل-مفعول»—يجب أن يؤكد كاشف النشاط الصوتي (VAD) اكتمال الجملة الفرعية للمتحدث. إن ضبط عتبة صمت نهاية الجملة لفترة قصيرة جدًا يقطع الترددات الذهنية الطبيعية إلى عبارات مشوهة، بينما يؤدي جعلها طويلة جدًا إلى تعطيل سلاسة تبادل أطراف الحديث.
تفكيك مسار زمن الاستجابة الشامل في الترجمة المباشرة
يمر كل ملف صوتي تلتقطه مصفوفة تشكيل الحزمة في السماعة عبر خمس مراحل متتالية: تأطير الإرسال الصاعد عبر Bluetooth SCO/LE Audio، ونافذة الصمت لكاشف النشاط الصوتي VAD، وتوليد رموز ASR المتدفقة، وإعادة ترتيب سياق الترجمة الآلية العصبية NMT، وتخليق فوكودر تحويل النص إلى كلام TTS. ورغم أن زمن الذهاب والإياب عبر شبكات 5G أو Wi-Fi يتراوح بين 80 و180 ميلي ثانية، فإن مؤقت VAD ينتظر عمدًا صمتًا صوتيًا بين 500 و1,200 ميلي ثانية لتأكيد نهاية الجملة.
تجبر اللغات التي ينتهي تركيبها بالفعل مخزن الترجمة المؤقت على احتجاز الكلمات حتى وصول المسند في نهاية الجملة تمامًا. وحتى عندما يعرض نظام ASR المتدفق الكلمات على شاشة هاتفك في غضون 300 ميلي ثانية، يحجب محرك الصوت TTS التشغيل الصوتي حتى اكتمال إعادة الترتيب النحوي، حتى لا يضطر الصوت الاصطناعي إلى التراجع وتصحيح العبارة في منتصف الجملة.
| مرحلة المسار | الميزانية الزمنية المعتادة (ms) | المكون المتحكم | أثر التقصير المفرط | استراتيجية التحسين |
|---|---|---|---|---|
| إرسال ميكروفون البلوتوث الصاعد | 40 – 90 ms | شريحة السماعة SoC ومكدس المضيف | فقدان الحزم في الأماكن المزدحمة بتردد 2.4 GHz | وضع الهاتف على مسافة 50 سم في الجانب غير المحجوب |
| صمت نقطة نهاية VAD | 500 – 1,200 ms | محرك الصوت في التطبيق المرافق | اقتطاع توقفات المتحدث وتقسيم الجمل النحوية | استخدام زر اللمس اليدوي لتحرير حدود الكلام |
| فك تشفير ASR المتدفق | 180 – 350 ms | السحابة أو وحدة المعالجة العصبية NPU بالهاتف | ارتفاع معدل الخطأ في الكلمات المتجانسة والأسماء | التحديد المسبق لملف المجال أو اللهجة الإقليمية |
| فوكودر TTS وبث A2DP | 200 – 380 ms | مخلق الكلام العصبي | نبرة آلية جافة واقتطاع نهايات الحروف الساكنة | ضبط سرعة تشغيل TTS على 1.15x في إعدادات التطبيق |
كيف تتحكم أوضاع المحادثة في توقيت نقطة نهاية ASR
نظرًا لصعوبة الكشف التلقائي عن التوقفات في الغرف ذات الصدى المرتفع حيث تحاكي ضوضاء المقاهي طاقة الكلام، تقسم التطبيقات المرافقة الترجمة إلى أوضاع تفاعل واضحة. في وضع اللمس (Touch Mode)، يؤدي النقر على ساق السماعة وتحريره يدويًا إلى إغلاق المخزن المؤقت فورًا، متجاوزًا نافذة انتظار VAD البالغة 800 ميلي ثانية وخافضًا إجمالي زمن الاستجابة إلى أقل من 1.2 ثانية.
يعتمد وضع التحدث الحر ووضع الاستماع المتزامن كليًا على عتبات طاقة VAD الخوارزمية وتشكيل حزمة الميكروفون المزدوج لعزل الأصوات. وللحفاظ على تدفق مسار الترجمة أثناء المحاضرات الطويلة أو التفسيرات متعددة الجمل، ينبغي للمتحدثين التوقف بوضوح لبرهة كاملة بين الأفكار المكتملة بدلاً من ربط الجمل بكلمات حشو مثل «آه» أو «وهكذا».
إراحة الأذنين بعد ساعات من الاستماع لأصوات TTS الاصطناعية
يفرض الاستماع المتواصل إلى أصوات تحويل النص إلى كلام المضغوطة بالتزامن مع تتبع متحدث حي بلغة أجنبية عبئًا إدراكيًا كبيرًا وضغطًا صوتيًا متوسط المدى على الأذن الداخلية. ومع عودتك إلى غرفة الفندق بعد يوم شاق من الاجتماعات متعددة اللغات، تبدو السماعات البارزة التقليدية مزعجة وصلبة عند الضغط عليها بالوسادة.
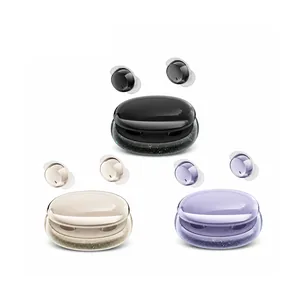
Flat, stemless earbuds for sleeping on your side, with a dynamic sleep-support mode and a starlight glow charging case. See the three colors at EARSOLE.
يتيح الانتقال من سماعات الترجمة بالذكاء الاصطناعي النهارية إلى تصميم النوم فائق النحافة إراحة صيوان الأذن وقناتها من الضغط الجانبي للوسادة. وبدلاً من الترددات الصوتية الحادة، تساعد المشاهد الصوتية المحيطية الهادئة على حجب أصوات خطوات الممرات وإعادة ضبط إجهادك السمعي خلال الليل.
عادات تحدث عملية تقلل تأخر الترجمة إلى النصف
يمكنك تقليص ما يقرب من ثانية كاملة من كل تبادل حواري عبر تعديل صياغة الجمل وإدارة قربك من الميكروفون. تحدث في جمل تقريرية موجزة تتكون من عشر إلى خمس عشرة كلمة مع توقف واضح عند نهاية كل جملة، وتجنب أدوات العطف الممتدة التي تخدع مخزن ASR الاستشرافي وتجعله ينتظر جملة تالية.
في البيئات الصاخبة التي تتجاوز 70 ديسيبل dBA، انتقل من كشف VAD التلقائي إلى تحرير اللمس اليدوي، وارفع سرعة تشغيل TTS إلى 1.15x حتى ينتهي الإخراج الصوتي قبل أن يبدأ الطرف الآخر جملته التالية. وإذا كنت في ظروف ينعدم فيها التجوال الخلوي تمامًا، فاطلع على تحليلنا الهندسي حول سماعات الترجمة بدون إنترنت وحزم اللغات المحلية لوحدة NPU.
الأسئلة الشائعة
لماذا يظهر النص المترجم على شاشة الهاتف قبل ثانية من سماع الصوت في السماعات؟
يعرض نظام ASR المتدفق الكلمات المقدرة جزئيًا أثناء تحدثك، لكن محركات الترجمة العصبية وتخليق الكلام TTS يجب أن تنتظر حتى نهاية الجملة النحوية لإعادة ترتيب الأفعال وتوليد نبرات صوتية طبيعية قبل إرسال الصوت إلى السماعات.
هل يلغي البلوتوث 5.3 أو 5.4 التأخير في سماعات الترجمة الفورية تمامًا؟
تعمل إصدارات البلوتوث الأحدث على تحسين استقرار الاتصال وكفاءة الطاقة، لكنها لا تختصر سوى بضع عشرات من الميلي ثانية من طبقة النقل اللاسلكي؛ بينما يأتي الجزء الأكبر من تأخير الترجمة من التخزين المؤقت للجمل النحوية ومؤقتات توقف VAD.