

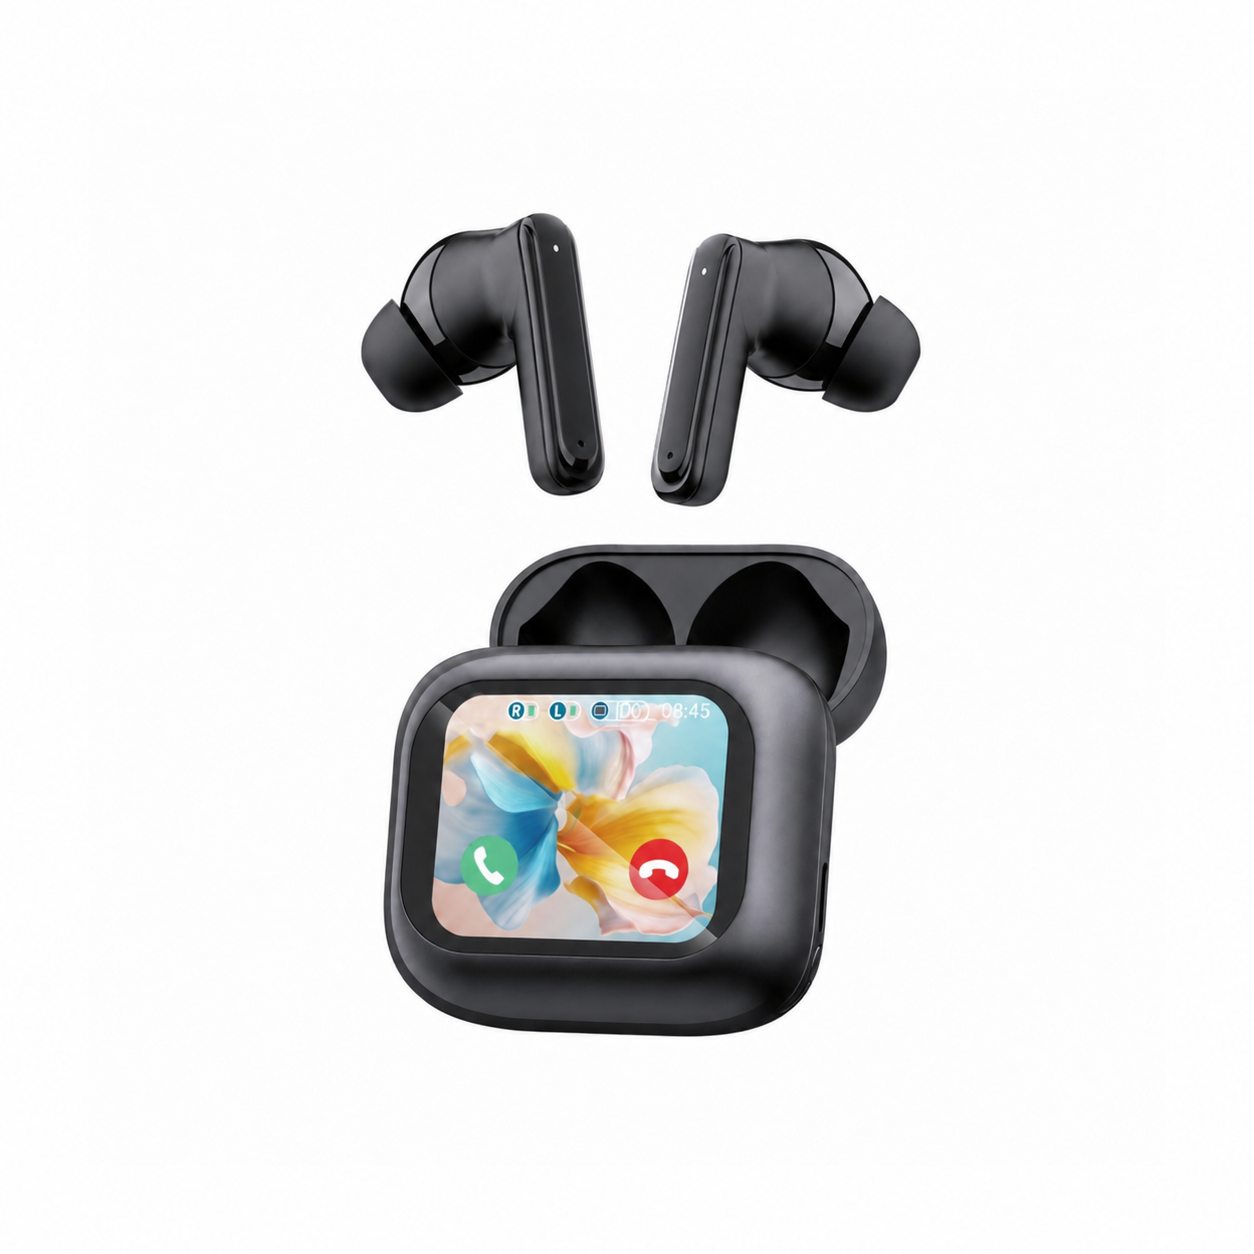
หูฟังแปลภาษาแบบเรียลไทม์และความหน่วงจากการหยุดพักตัดประโยคของ ASR ในบทสนทนาสด
วิดีโอสาธิตทางการตลาดของหูฟังแปลภาษาแบบเรียลไทม์มักทำให้รู้สึกเหมือนมีเสียงพากย์แปลออกมาในทันที แต่ใครก็ตามที่นำไปใช้งานจริงในสถานีรถไฟโตเกียวที่พลุกพล่านหรือบูทงานแสดงสินค้าในมิลาน จะสังเกตเห็นช่องว่างความเงียบประมาณ 2 ถึง 4 วินาทีก่อนที่เสียงแปลจะดังขึ้นในหู ความล่าช้านี้แทบไม่ได้เกิดจากการส่งสัญญาณบลูทูธที่ช้าหรือเซิร์ฟเวอร์คลาวด์ที่อืด แต่คอขวดหลักอยู่ที่การตรวจจับขอบเขตทางภาษาและเสียงพูดภายในระบบรู้จำเสียงพูดอัตโนมัติ (ASR)
ก่อนที่โมเดลการแปลภาษาด้วยระบบประสาทจะแปลงประโยคพูดระหว่างภาษาที่มีโครงสร้างไวยากรณ์สลับลำดับกัน เช่น ภาษาญี่ปุ่นที่กริยาอยู่ท้ายประโยค (SOV) ไปเป็นภาษาอังกฤษ (SVO) ตัวตรวจจับกิจกรรมเสียงพูด (VAD) จะต้องยืนยันให้แน่ชัดก่อนว่าผู้พูดจบคู่ประโยคหรืออนุประโยคนั้นแล้ว หากตั้งค่าเกณฑ์ความเงียบท้ายประโยคสั้นเกินไป การหยุดคิดเพียงชั่วครู่จะถูกตัดออกเป็นท่อนๆ จนฟังไม่รู้เรื่อง แต่หากตั้งค่ายาวเกินไป จังหวะการโต้ตอบตามธรรมชาติจะสะดุดและเงียบหายไปนาน
ถอดรหัสขั้นตอนความหน่วงแบบครบวงจรในการแปลภาษาแบบเรียลไทม์
ทุกถ้อยคำที่อาร์เรย์ไมโครโฟนบีมฟอร์มมิงของหูฟังดักจับได้ จะต้องผ่านขั้นตอนต่อเนื่อง 5 ขั้นตอน ได้แก่ การจัดเฟรมอัปลิงก์ Bluetooth SCO/LE Audio, หน้าต่างการตรวจจับความเงียบ VAD, การสร้างโทเค็น ASR แบบสตรีมมิง, การจัดลำดับบริบทไวยากรณ์ด้วย NMT และการสังเคราะห์เสียงโวโคเดอร์ TTS แม้ว่าเวลาในการรับส่งข้อมูลเครือข่าย 5G หรือ Wi-Fi จะเฉลี่ยเพียง 80 ถึง 180 มิลลิวินาที แต่ตัวจับเวลาจุดสิ้นสุดของ VAD จะต้องรอความเงียบ 500 ถึง 1,200 มิลลิวินาทีอย่างตั้งใจเพื่อระบุการสิ้นสุดประโยค
ภาษาที่มีโครงสร้างคำกริยาอยู่ท้ายประโยคบังคับให้บัฟเฟอร์การแปลต้องกักเก็บคำทั้งหมดไว้จนกว่าคำกริยาภาคแสดงจะมาถึงในตอนท้ายสุด แม้ว่าสตรีมมิง ASR จะแปลงคำพูดเป็นตัวอักษรขึ้นบนหน้าจอสมาร์ตโฟนได้ภายใน 300 มิลลิวินาที แต่ระบบเสียง TTS จะระงับการสังเคราะห์เสียงพูดไว้ก่อนจนกว่าการเรียงลำดับไวยากรณ์จะเสร็จสมบูรณ์ เพื่อไม่ให้เสียงสังเคราะห์ต้องย้อนกลับไปแก้ไขข้อความกลางประโยค
| ขั้นตอนประมวลผล | งบประมาณเวลาทั่วไป (ms) | ส่วนประกอบที่ควบคุม | ผลกระทบจากการลดเวลาลงมากเกินไป | กลยุทธ์การปรับแต่งให้เหมาะสม |
|---|---|---|---|---|
| อัปลิงก์ไมโครโฟนบลูทูธ | 40 – 90 ms | ชิป SoC หูฟังและสแตกฝั่งโฮสต์ | ข้อมูลสูญหายในพื้นที่ความถี่ 2.4 GHz แออัด | วางโทรศัพท์ให้อยู่ในระยะ 50 ซม. ด้านที่ไม่มีสิ่งกีดขวาง |
| ความเงียบสิ้นสุดประโยค VAD | 500 – 1,200 ms | เอนจินเสียงของแอปพลิเคชัน | ตัดจังหวะหยุดพูดและทำให้ประโยคแยกส่วน | ใช้โหมดแตะปล่อยเพื่อสั่งตัดประโยคด้วยตนเอง |
| ถอดรหัสสตรีมมิง ASR | 180 – 350 ms | ชิป NPU บนคลาวด์หรือสมาร์ตโฟน | อัตราข้อผิดพลาดของคำพ้องเสียงและชื่อเฉพาะสูงขึ้น | เลือกโปรไฟล์คำศัพท์เฉพาะทางหรือสำเนียงล่วงหน้า |
| โวโคเดอร์ TTS และ A2DP | 200 – 380 ms | โมเดลสังเคราะห์เสียงนิวรัล | น้ำเสียงแข็งเป็นหุ่นยนต์และพยัญชนะท้ายถูกตัด | ปรับความเร็วเสียงอ่าน TTS เป็น 1.15x ในการตั้งค่าแอป |
โหมดการสนทนาควบคุมจังหวะการตัดประโยคของ ASR อย่างไร
เนื่องจากการตรวจจับการหยุดพักแบบอัตโนมัติมักทำงานคลาดเคลื่อนในห้องที่มีเสียงก้องหรือเสียงกระทบของถ้วยชามในคาเฟ่ซึ่งมีพลังงานคล้ายเสียงพูด แอปคู่หูจึงแบ่งการแปลออกเป็นโหมดการโต้ตอบที่ชัดเจน ในโหมดสัมผัส (Touch Mode หรือกดเพื่อพูด) การแตะแล้วปล่อยก้านหูฟังจะช่วยปิดบัฟเฟอร์เสียงได้ทันทีด้วยตนเอง ตัดช่วงเวลารอของ VAD ที่นาน 800 มิลลิวินาทีออกไป และลดความหน่วงการตอบสนองโดยรวมลงเหลือต่ำกว่า 1.2 วินาที
ส่วนโหมดสนทนาอิสระ (Free-Talk) และโหมดฟังแบบพร้อมกัน (Simultaneous Listening) จะอาศัยเกณฑ์พลังงาน VAD ตามอัลกอริทึมและบีมฟอร์มมิงไมโครโฟนคู่เพื่อแยกเสียงพูดอย่างสมบูรณ์ เพื่อให้ขั้นตอนการแปลลื่นไหลอย่างต่อเนื่องระหว่างการบรรยายยาวๆ หรือการอธิบายที่มีหลายอนุประโยค ผู้พูดควรหยุดเว้นจังหวะให้ชัดเจนหนึ่งจังหวะเต็มๆ ระหว่างความคิดที่สมบูรณ์ แทนที่จะเชื่อมประโยคยาวเหยียดด้วยคำฟุ่มเฟือยอย่าง “เอ่อ” หรือ “แล้วก็”
การพักผ่อนหูหลังจากการฟังเสียงสังเคราะห์ TTS ต่อเนื่องหลายชั่วโมง
การฟังเสียงสังเคราะห์สังเคราะห์จากข้อความเป็นเสียงพูด (TTS) ที่บีบอัด ควบคู่ไปกับการตั้งใจฟังคู่สนทนาที่เป็นภาษาต่างประเทศสร้างภาระทางสมองอย่างหนัก และทำให้เกิดแรงดันเสียงย่านความถี่กลางสะสมในหูชั้นในอย่างต่อเนื่อง เมื่อคุณกลับถึงห้องพักในโรงแรมหลังจากประชุมข้ามภาษามาทั้งวัน หูฟังทรงยื่นทั่วไปจะรู้สึกแข็งกระด้างและกดทับจนเจ็บเมื่อนอนแนบหมอน
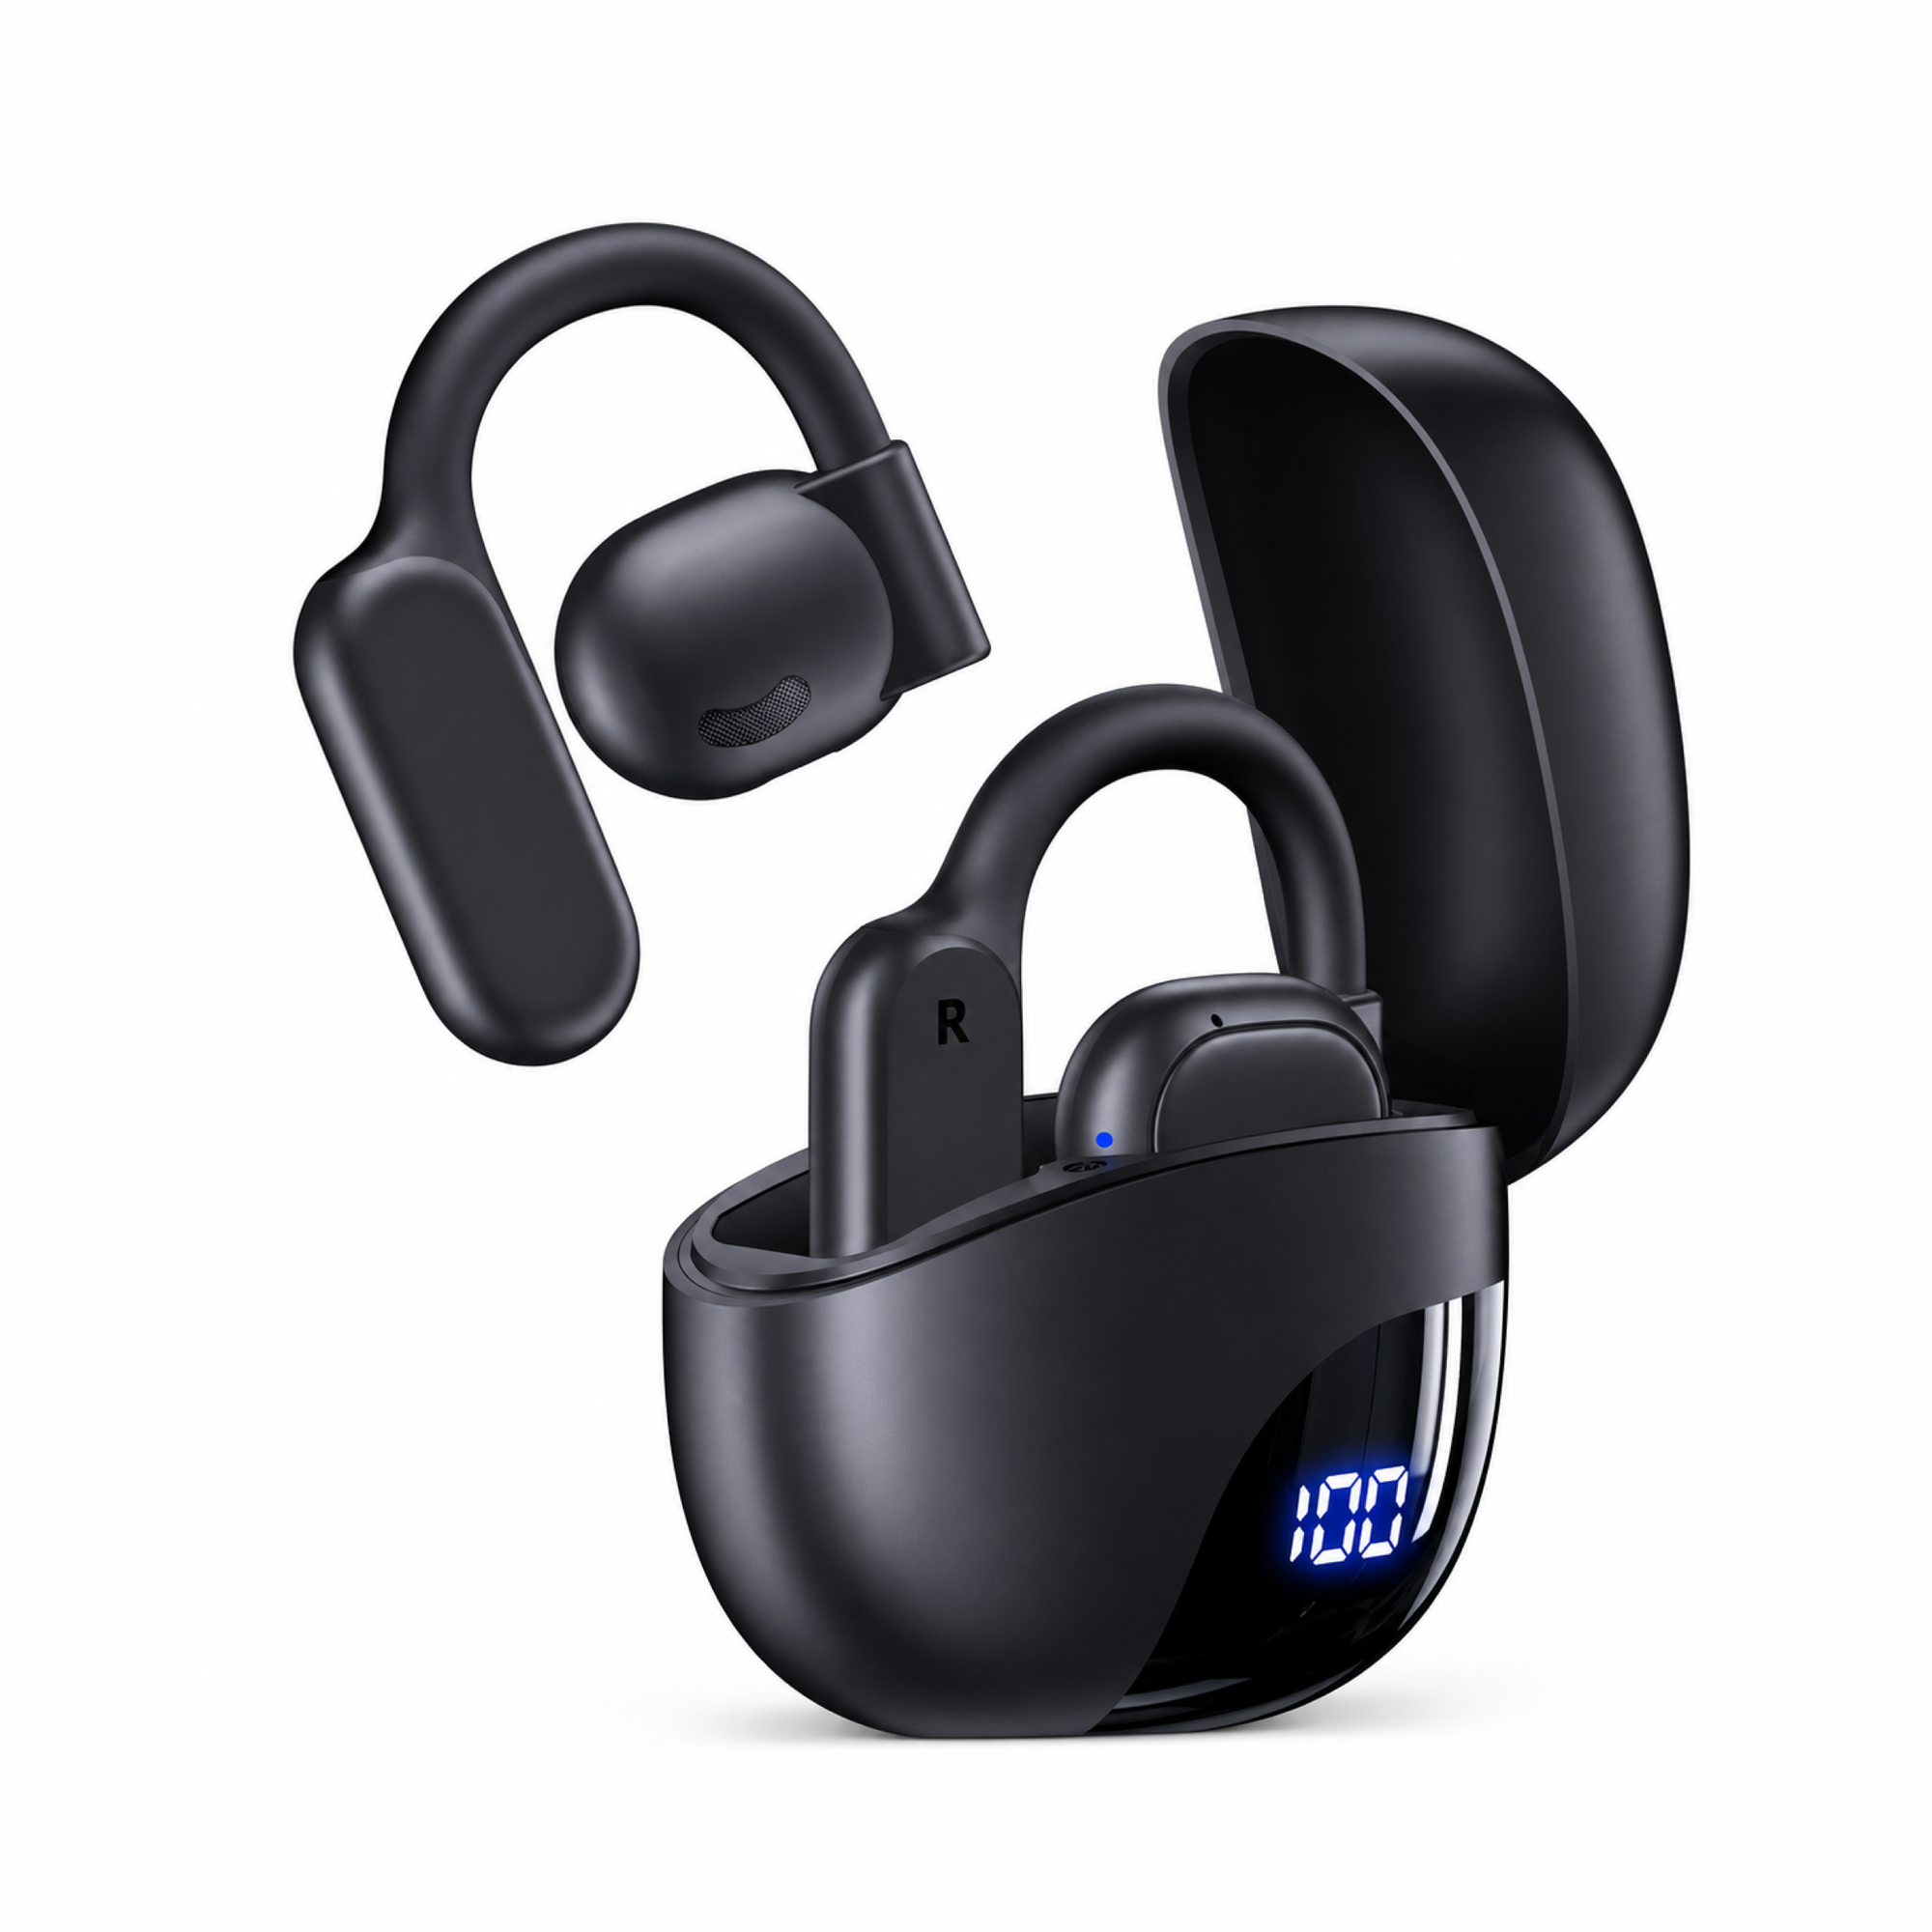
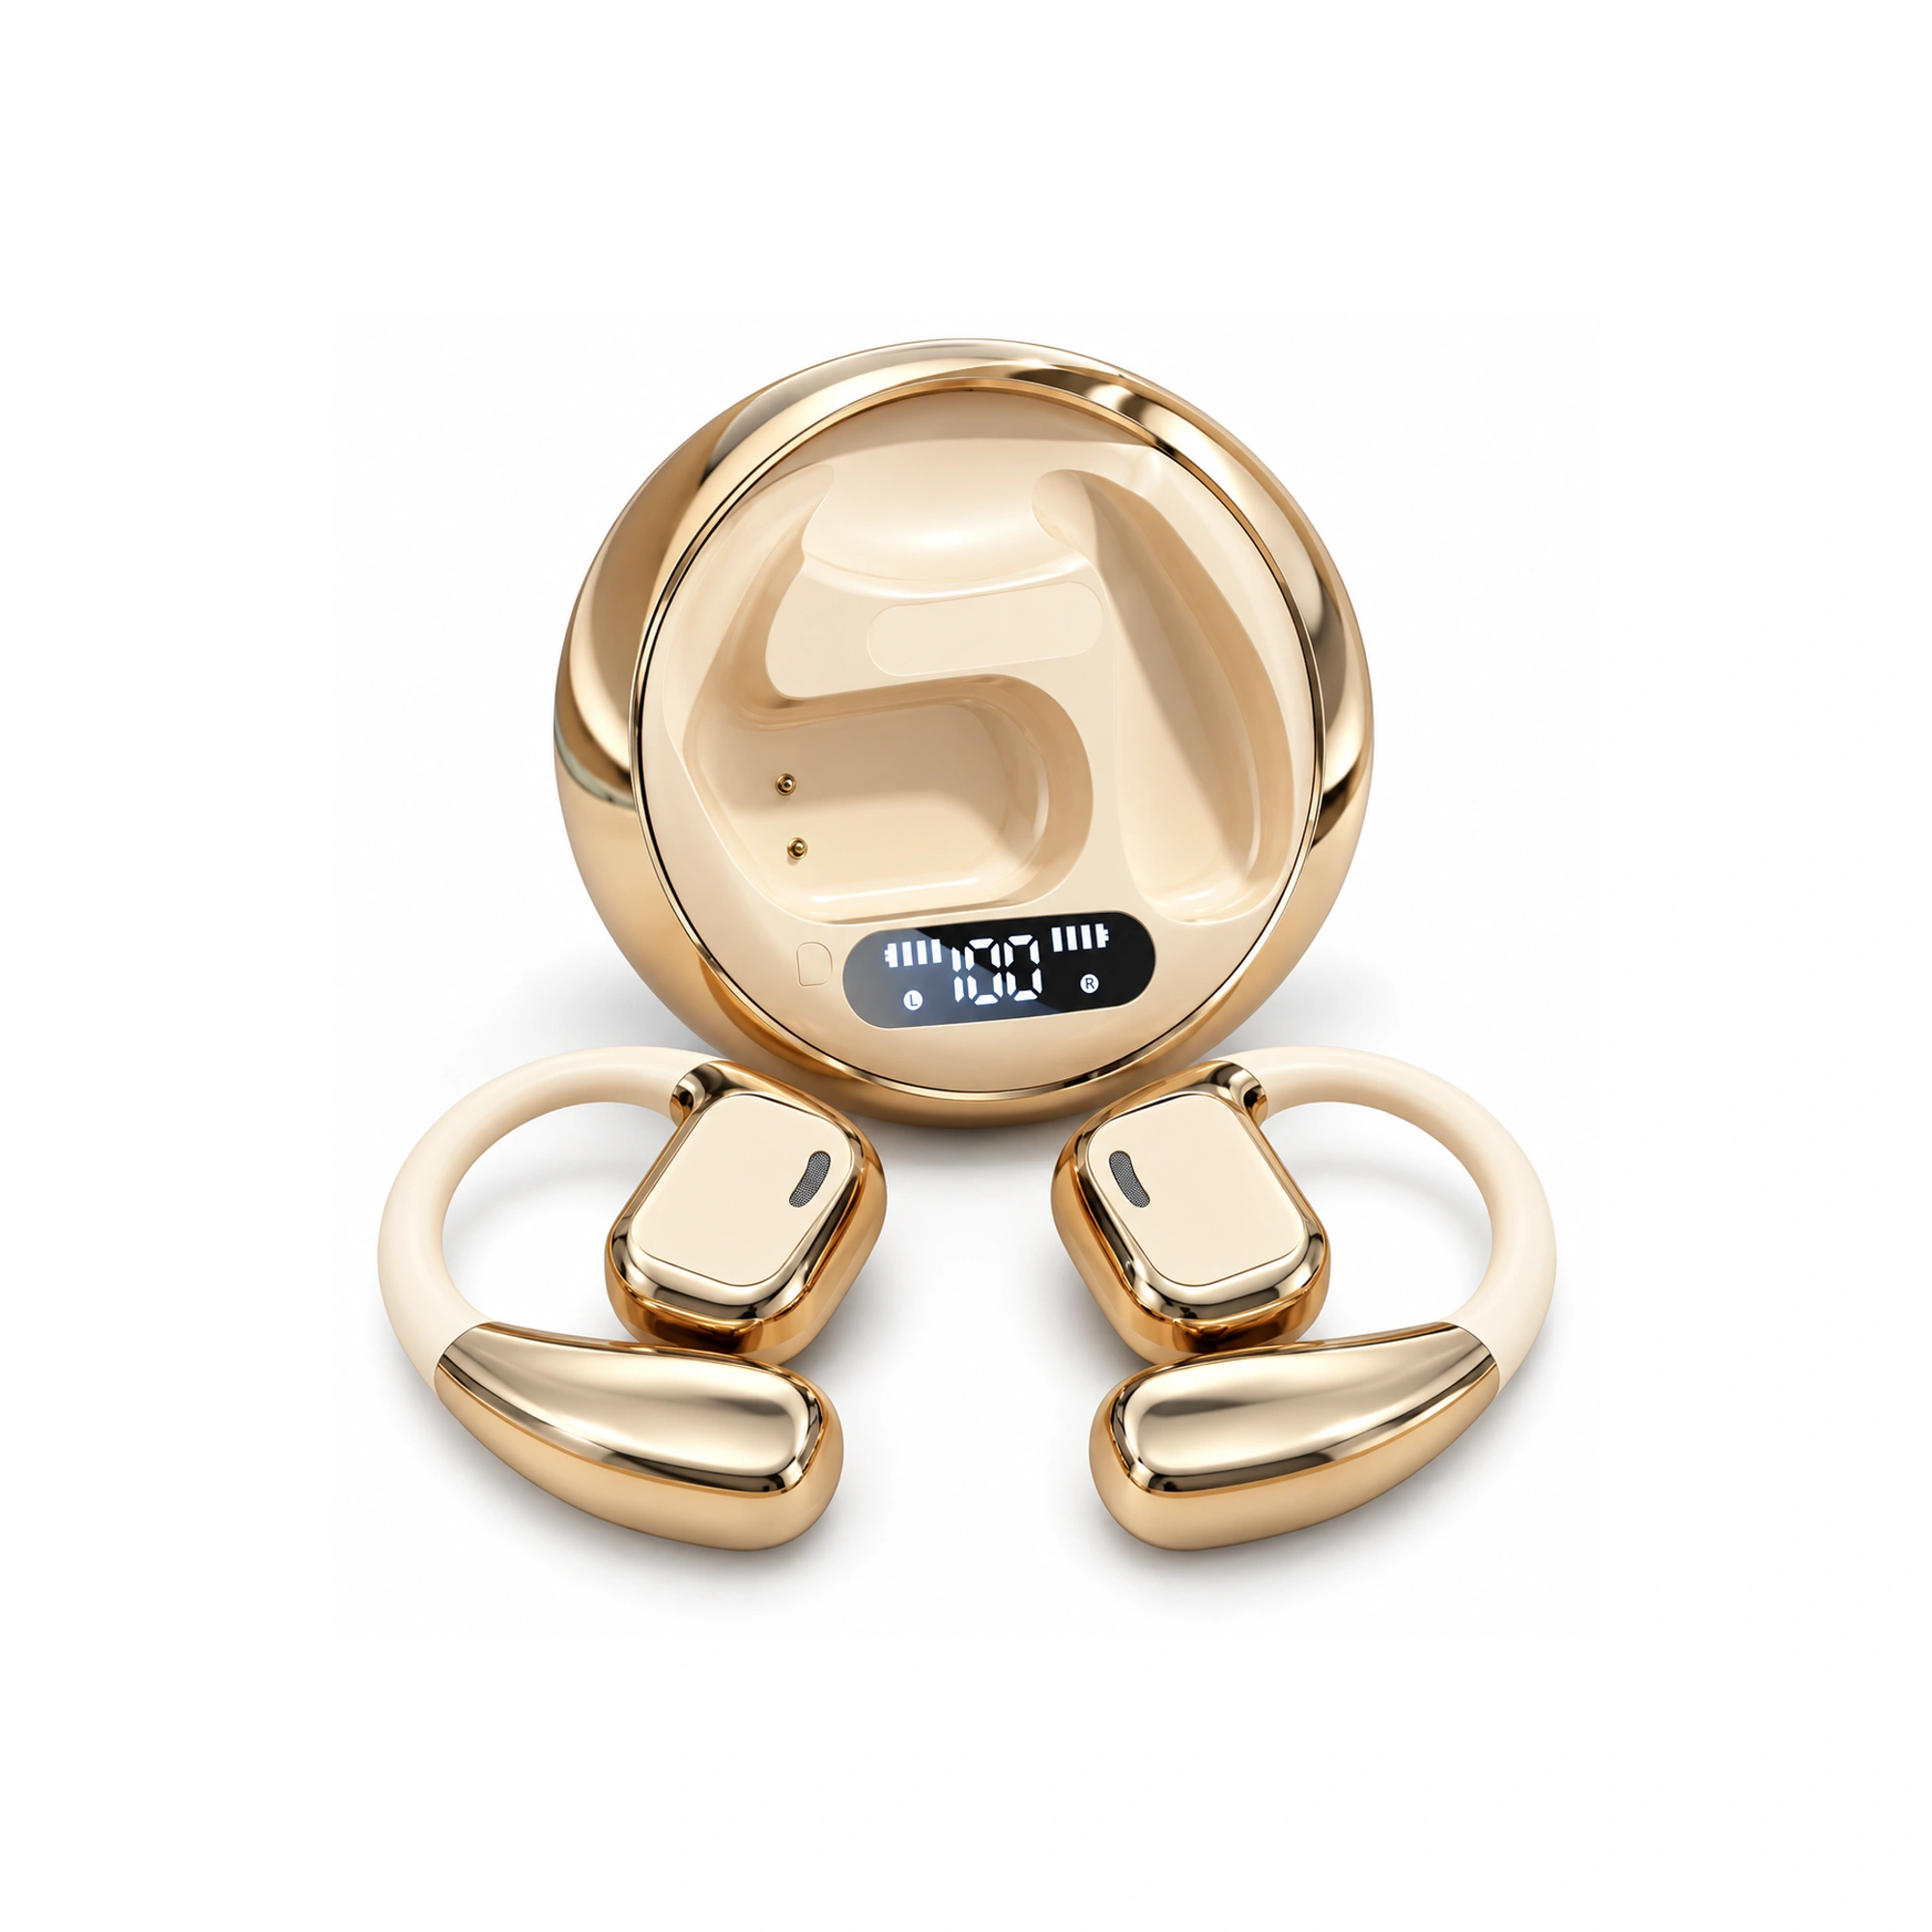
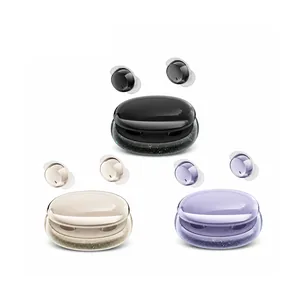
Flat, stemless earbuds for sleeping on your side, with a dynamic sleep-support mode and a starlight glow charging case. See the three colors at EARSOLE.
การเปลี่ยนจากหูฟังแปลภาษา AIที่ใช้ระหว่างวันมาเป็นหูฟังสำหรับใส่นอนทรงบางพิเศษ ช่วยให้ใบหูและช่องหูได้คลายแรงกดทับด้านข้างจากหมอน เสียงบรรยากาศนุ่มนวลจะช่วยกลบเสียงฝีเท้าตามทางเดินแทนคลื่นเสียงพูดที่แหลมคม ช่วยฟื้นฟูอาการล้าของระบบการได้ยินตลอดทั้งคืน
นิสัยการพูดที่นำไปใช้ได้จริงเพื่อลดความหน่วงในการแปลลงครึ่งหนึ่ง
คุณสามารถลดเวลารอในการสนทนาลงได้เกือบหนึ่งวินาทีเต็มเพียงปรับเปลี่ยนวิธีการเรียบเรียงประโยคและระยะห่างของไมโครโฟน โดยพูดเป็นอนุประโยคสั้นๆ ชัดเจนประมาณสิบถึงสิบห้าคำพร้อมทั้งหยุดอย่างเด็ดขาดที่ท้ายประโยค และหลีกเลี่ยงการทิ้งท้ายด้วยคำเชื่อมยืดเยื้อที่ทำให้บัฟเฟอร์ล่วงหน้าของ ASR หลงรอฟังประโยคถัดไป
ในสภาพแวดล้อมที่มีเสียงดังเกิน 70 dBA ควรเปลี่ยนจากการตรวจจับ VAD แบบแฮนด์ฟรีมาเป็นการแตะปล่อยด้วยตนเอง และปรับความเร็วเสียง TTS เป็น 1.15x เพื่อให้เสียงแปลเล่นจบก่อนที่คู่สนทนาจะเริ่มพูดประโยคต่อไป และสำหรับสถานการณ์ที่ไม่มีสัญญาณโรมมิงมือถือเลย สามารถดูรายละเอียดเชิงลึกทางวิศวกรรมเกี่ยวกับหูฟังแปลภาษาแบบออฟไลน์และชุดภาษาบนชิป NPU ในอุปกรณ์ของเราได้
คำถามที่พบบ่อย
ทำไมข้อความแปลถึงปรากฏบนหน้าจอโทรศัพท์ก่อนที่จะได้ยินเสียงในหูฟังประมาณหนึ่งวินาที?
ระบบสตรีมมิง ASR จะแสดงการคาดเดาคำออกมาเป็นตัวอักษรทันทีที่คุณกำลังพูด แต่ระบบแปลภาษาด้วยนิวรัลและเอนจินสังเคราะห์เสียง TTS จำเป็นต้องรอจนจบอนุประโยคทางไวยากรณ์เพื่อเรียงลำดับคำกริยาและสร้างระดับเสียงสูงต่ำที่เป็นธรรมชาติ ก่อนที่จะส่งสัญญาณเสียงกลับไปเล่นที่หูฟัง
เทคโนโลยี Bluetooth 5.3 หรือ 5.4 ช่วยขจัดความหน่วงในหูฟังแปลภาษาแบบเรียลไทม์ได้หมดหรือไม่?
เวอร์ชันบลูทูธที่ใหม่กว่าช่วยเพิ่มความเสถียรในการเชื่อมต่อและประหยัดพลังงานได้จริง แต่สามารถลดเวลาในระดับชั้นการรับส่งข้อมูลไร้สายได้เพียงไม่กี่สิบมิลลิวินาทีเท่านั้น ความล่าช้าส่วนใหญ่ในการแปลยังคงเกิดจากการบัฟเฟอร์ประโยคทางภาษาและตัวจับเวลาการหยุดพักของ VAD