

Słuchawki do tłumaczenia w czasie rzeczywistym a opóźnienie pauzy ASR w rozmowach na żywo
Prezentacje marketingowe słuchawek do tłumaczenia w czasie rzeczywistym często sugerują natychmiastowy dubbing, jednak każdy, kto korzystał z nich na zatłoczonym dworcu w Tokio lub na targach w Mediolanie, zauważa wyraźną dwu- lub czterosekundową przerwę przed pojawieniem się przetłumaczonego głosu w uchu. To opóźnienie rzadko wynika z powolnej transmisji Bluetooth czy przeciążonych serwerów chmurowych; główną barierą jest detekcja granic akustycznych i lingwistycznych w silniku automatycznego rozpoznawania mowy (ASR).
Zanim neuronowy model tłumaczenia maszynowego przekształci wypowiedź między językami o odmiennym szyku zdań — na przykład z japońskiego o strukturze Podmiot-Dopełnienie-Orzeczenie na polski lub angielski o szyku Podmiot-Orzeczenie-Dopełnienie — detektor aktywności głosowej (VAD) musi potwierdzić, że mówca zakończył całą frazę gramatyczną. Ustawienie zbyt krótkiego progu ciszy końcowej rwie naturalne zawieszenia głosu na zniekształcone fragmenty, natomiast zbyt długi próg paraliżuje płynność dialogu.
Rozłożenie potoku opóźnień transmisji w tłumaczeniu na żywo
Każda wypowiedź zarejestrowana przez matrycę mikrofonów kierunkowych przechodzi przez pięć kolejnych faz: ramkowanie łącza Bluetooth SCO/LE Audio, okno ciszy detektora VAD, strumieniowe generowanie tokenów ASR, dopasowanie kontekstu w neuronowym tłumaczeniu maszynowym (NMT) oraz syntezę mowy vocodera TTS. Podczas gdy czas podróży pakietu przez sieć 5G lub Wi-Fi wynosi średnio od 80 do 180 milisekund, licznik końcowy VAD celowo odczekuje od 500 do 1200 milisekund ciszy, aby precyzyjnie wyznaczyć granicę zdania.
Języki z orzeczeniem na końcu zdania wymuszają buforowanie tokenów aż do momentu, gdy czasownik pojawi się na samym końcu frazy. Nawet jeśli strumieniowy ASR wyświetla transkrybowane słowa na ekranie smartfona w ciągu 300 milisekund, silnik audio TTS wstrzymuje odtwarzanie głosu do momentu uporządkowania składni, dzięki czemu syntezator nie musi urywać ani korygować intonacji w połowie zdania.
| Etap potoku | Typowy budżet czasu (ms) | Element kontrolujący | Skutek nadmiernego skrócenia | Strategia optymalizacji |
|---|---|---|---|---|
| Łącze mikrofonowe Bluetooth | 40 – 90 ms | SoC słuchawek i stos hosta | Utrata pakietów w zatłoczonym paśmie 2,4 GHz | Trzymać telefon w odległości do 50 cm bez przeszkód |
| Cisza końcowa detektora VAD | 500 – 1200 ms | Silnik audio aplikacji mobilnej | Ucinanie pauz mówcy i dzielenie zdań | Stosować ręczne zatwierdzanie pauzy dotykiem |
| Strumieniowe dekodowanie ASR | 180 – 350 ms | Chmura lub lokalny NPU | Wyższy błąd homofonów i nazw własnych | Wstępnie wybrać profil dziedziny lub dialektu |
| Synteza NMT i TTS | 350 – 830 ms | Model tłumaczeniowy i vocoder | Monotonna intonacja i ucięte głoski | Mówić zwięzłymi zdaniami; ustawić TTS na 1,15x |
Jak tryby konwersacji sterują punktem odcięcia ASR
Ponieważ automatyczne wykrywanie pauzy zawodzi w pomieszczeniach z pogłosem, gdzie hałas kawiarni imituje energię mowy, aplikacje towarzyszące oferują różne tryby interakcji. W trybie dotykowym (Press-to-Talk) naciśnięcie i zwolnienie trzonka słuchawki manualnie zamyka bufor audio, co eliminuje 800-milisekundowe oczekiwanie VAD i obniża łączny czas odpowiedzi poniżej 1,2 sekundy.
Tryby swobodnej rozmowy i jednoczesnego nasłuchu polegają w pełni na algorytmicznych progach energetycznych VAD oraz filtracji przestrzennej mikrofonów. Aby zachować płynny transfer zdań podczas dłuższych prezentacji lub złożonych wypowiedzi, rozmówcy powinni robić wyraźną, jednosekundową przerwę między pełnymi myślami, zamiast łączyć zdania dźwiękami namysłu w rodzaju „yyy” czy „no i”.
Odpoczynek dla uszu po wielu godzinach syntetycznego głosu TTS
Słuchanie skompresowanego głosu z syntezatora mowy przy jednoczesnym śledzeniu wypowiedzi rozmówcy w obcym języku wywołuje duże obciążenie poznawcze i ciągły nacisk akustyczny w paśmie średnich częstotliwości. Po powrocie do pokoju hotelowego po całym dniu wielojęzycznych negocjacji standardowe wystające słuchawki uwierają i powodują dyskomfort przy oparciu głowy na poduszce.
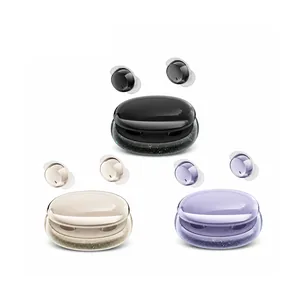
Flat, stemless earbuds for sleeping on your side, with a dynamic sleep-support mode and a starlight glow charging case. See the three colors at EARSOLE.
Zamiana noszonych w ciągu dnia słuchawek z tłumaczeniem AI na smukłe, miniaturowe pchełki do spania pozwala małżowinie i kanałowi słuchowemu odpocząć od bocznego nacisku poduszki. Zamiast sztywnych tonów syntezatora, łagodne tła dźwiękowe maskują kroki na korytarzu i ułatwiają regenerację słuchu przez noc.
Praktyczne nawyki w mówieniu, które skracają opóźnienie o połowę
Możesz zaoszczędzić niemal całą sekundę w każdej wymianie zdań, modyfikując sposób formułowania myśli i dbając o właściwą odległość mikrofonu. Formułuj zwięzłe zdania oznajmujące o długości dziesięciu do piętnastu słów z wyraźną kropką na końcu i unikaj przeciąganych spójników, które zmuszają bufor ASR do niepotrzebnego wyczekiwania kolejnej frazy.
W hałaśliwym otoczeniu powyżej 70 dBA zrezygnuj z automatycznego wykrywania głosu na rzecz ręcznego sterowania dotykiem oraz zwiększ tempo odtwarzania TTS do 1,15x, aby przetłumaczona kwestia wybrzmiała, zanim rozmówca zacznie kolejne zdanie. W sytuacjach bez dostępu do roamingu danych sprawdź nasz przewodnik inżynieryjny po słuchawkach do tłumaczenia offline i pakietach językowych dla lokalnych układów NPU.
Często zadawane pytania
Dlaczego przetłumaczony tekst pojawia się na ekranie telefonu wcześniej, niż słychać głos w słuchawkach?
Strumieniowy ASR wyświetla wstępne rozpoznania słów w trakcie wypowiedzi, lecz moduły tłumaczenia neuronowego i syntezy mowy muszą poczekać na zakończenie całej frazy gramatycznej, by uporządkować czasowniki i nadać naturalną intonację przed przesłaniem dźwięku do słuchawek.
Czy Bluetooth 5.3 lub 5.4 likwiduje opóźnienia w słuchawkach do tłumaczenia na żywo?
Nowsze wersje Bluetooth poprawiają stabilność połączenia i zmniejszają zużycie energii, ale skracają czas transmisji radiowej zaledwie o kilkadziesiąt milisekund; zasadnicza część opóźnienia wynika z buforowania struktur zdaniowych oraz czasu oczekiwania detektora VAD na pauzę.