

Sanntidsoversettelsesørepropper og ASR-pauseforsinkelse i direkte samtaler
Markedsføringsvideoer for sanntidsoversettelsesørepropper gir ofte inntrykk av umiddelbar dubbing, men enhver som har prøvd dem på en travel stasjon i Tokyo eller på en messe i Milano merker et merkbart opphold på to til fire sekunder før den oversatte stemmen høres i øret. Denne forsinkelsen skyldes sjelden treg Bluetooth-overføring eller trege skyservere; den største flaskehalsen er akustisk og språklig grensedeteksjon i ASR-motoren (automatisk talegjenkjenning).
Før en nevral maskinoversettelsesmodell kan oversette en ytring mellom språk med ulik ordstilling — for eksempel fra japansk (Subjekt-Objekt-Verb) til engelsk eller norsk (Subjekt-Verb-Objekt) — må taleaktivitetsdetektoren (VAD) bekrefte at taleren har fullført setningsleddet. Settes terskelen for pauseslutt for kort, kuttes naturlige pauser opp i uforståelige bruddstykker, mens en for lang terskel gjør turtakingen i samtalen unaturlig treg.
Dekonstruksjon av forsinkelsesleddene ved direkteoversettelse
Hver ytring som fanges opp av mikrofonene i øreproppene går gjennom fem påfølgende faser: Bluetooth SCO/LE Audio-rammer, VAD-pausevindu, løpende ASR-tokengenerering, konteksttilpasning i nevral maskinoversettelse (NMT) og vocoder-syntese for tekst-til-tale (TTS). Mens nettverkstransport over 5G eller Wi-Fi i snitt tar 80 til 180 millisekunder, venter VAD-tidsuret bevisst i 500 til 1200 millisekunder med stillhet for å registrere at en setning er ferdig.
Språk med verbet til slutt tvinger oversettelsesbufferen til å holde igjen ord inntil hovedverbet dukker opp på slutten av leddet. Selv når løpende ASR viser ordene på mobilskjermen innen 300 millisekunder, holder TTS-lydmotoren tilbake stemmegjengivelsen til syntaksen er ferdig ordnet, slik at den syntetiske stemmen slipper å rette seg selv midt i setningen.
| Fasedel i kjeden | Typisk tidsbruk (ms) | Styrende komponent | Konsekvens ved for aggressiv forkorting | Optimaliseringsstrategi |
|---|---|---|---|---|
| Bluetooth mikrofon-uplink | 40 – 90 ms | Ørepropp-SoC og vertsoperativsystem | Pakketap i tette 2,4 GHz-miljøer | Ha telefonen innen 50 cm uten hindringer |
| VAD-sluttpause | 500 – 1200 ms | Appens interne lydmotor | Kutter naturlige pauser og deler opp ledd | Bruk manuell trykk-for-å-tale-utløser |
| Løpende ASR-avkoding | 180 – 350 ms | Sky eller lokal NPU | Flere feil på homofoner og egennavn | Forhåndsvelg domene eller dialektprofil |
| NMT- og TTS-syntese | 350 – 830 ms | Oversettelsesmodell og vocoder | Robotaktig tonefall og avkuttede lyder | Snakk i korte ledd; sett TTS-hastighet til 1,15x |
Hvordan samtalemodi styrer ASR-tidspunktene
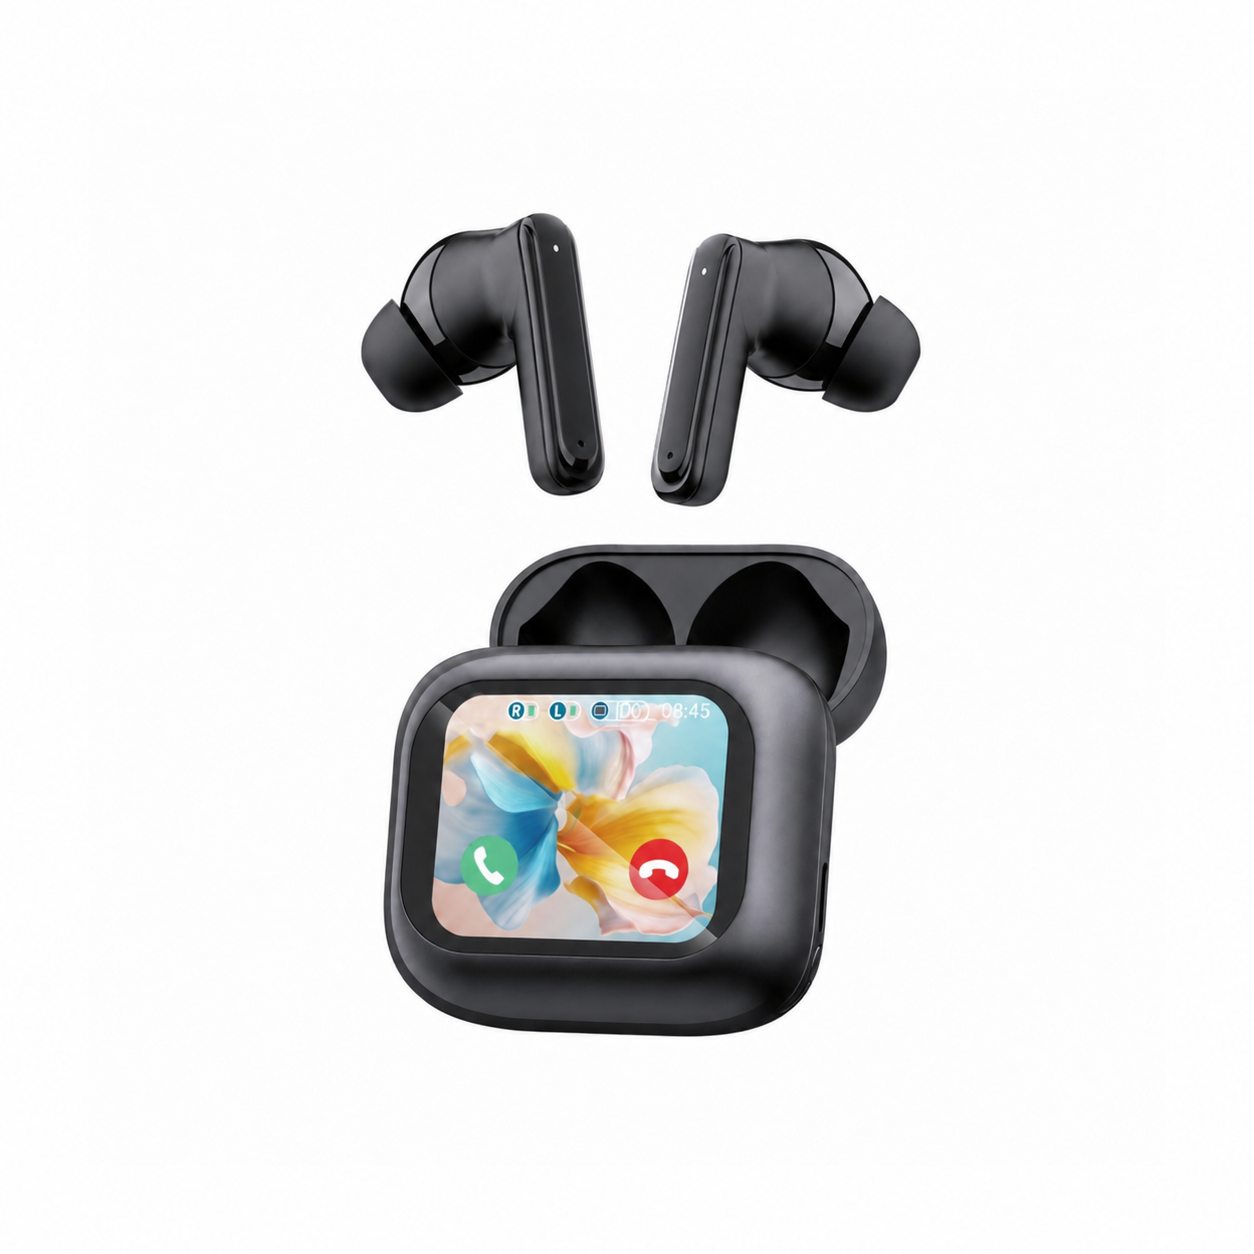
Siden automatisk pausedeteksjon lett blir forvirret i rom med mye etterklang der kaféstøy minner om taleenergi, deler appene oversettelsen inn i ulike moduser. I berøringsmodus (Press-to-Talk) lukker du lydbufferen manuelt ved å trykke på stilken på øreproppen, noe som fjerner VAD-ventetiden på 800 millisekunder og senker den totale responstiden til under 1,2 sekunder.
Fri tale og simultanlytting baserer seg derimot helt på algoritmiske terskler i VAD og stråleformende mikrofoner for å skille stemmer. For å holde god flyt under lengre foredrag eller resonnementer bør man legge inn en tydelig, rolig pause mellom hver fullførte tanke i stedet for å koble setninger sammen med fyllord som «øh» eller «og så».
Hvile for ørene etter mange timer med syntetisk TTS-tale
Å lytte til komprimert tekst-til-tale-lyd samtidig som du følger en taler på et annet språk krever mye konsentrasjon og skaper et jevnt mellomtonetrykk i øregangen. Når du kommer tilbake til hotellrommet etter en lang dag med møter, føles vanlige, utstikkende ørepropper harde og ubehagelige mot puten.
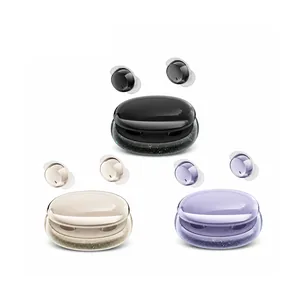
Flat, stemless earbuds for sleeping on your side, with a dynamic sleep-support mode and a starlight glow charging case. See the three colors at EARSOLE.
Ved å bytte ut dagens AI-oversettelsesørepropper med en flat sovepropp kan det ytre øret og øregangen slappe av uten sideveis press mot puten. I stedet for skarpe stemmefrekvenser maskerer myke bakgrunnslyder skritt i gangen og gir hørselen ro til å hente seg inn over natten.
Praktiske talevaner som kutter forsinkelsen i to
Du kan fjerne nesten et helt sekund i hver replikkveksling bare ved å tilpasse setningsstrukturen og passe på avstanden til mikrofonen. Snakk i klare setninger på ti til femten ord med et tydelig punktum, og unngå hengende bindeord som lurer ASR-bufferen til å vente på nok et ledd.
I støyfylte omgivelser over 70 dBA lønner det seg å gå over til manuell styring fremfor automatisk VAD, og øke avspillingshastigheten for TTS til 1,15x slik at oversettelsen blir ferdig før motparten begynner å svare. For turer uten mobildekning kan du lese vår tekniske gjennomgang av frakoblede oversettelsesørepropper og lokale NPU-språkpakker.
Ofte stilte spørsmål
Hvorfor vises den oversatte teksten på mobilen før jeg hører stemmen i øreproppene?
Løpende ASR viser fortløpende gjetninger av ord mens du snakker, men den nevrale oversettelsen og talesyntesen må vente til hele setningsleddet er fullført for å tilpasse ordstilling og intonasjon før lyden sendes til øret.
Fjerner Bluetooth 5.3 eller 5.4 forsinkelsen i sanntidsoversettelse?
Nyere Bluetooth-versjoner gir mer stabil kobling og lavere strømforbruk, men kutter bare noen titalls millisekunder på det trådløse sambandet; mesteparten av forsinkelsen skyldes setningsbuffring og tidsinnstillingene i VAD-pausesensoren.