

Auricolari di traduzione in tempo reale e latenza di pausa ASR a fine frase
Le presentazioni commerciali degli auricolari per la traduzione in tempo reale lasciano spesso intendere un doppiaggio istantaneo, ma chiunque li indossi in una stazione trafficata a Tokyo o presso uno stand fieristico a Milano sperimenta un intervallo netto di due o quattro secondi prima di ascoltare l’audio tradotto. Quel ritardo è raramente imputabile alla connessione Bluetooth o a server cloud lenti; l’ostacolo principale è il rilevamento dei confini linguistici e acustici operato dal motore di riconoscimento vocale (ASR).
Prima che un modello di traduzione neurale possa convertire una frase tra idiomi con ordini dei costituenti opposti (come la struttura Soggetto-Oggetto-Verbo del giapponese verso Soggetto-Verbo-Oggetto dell’italiano o dell’inglese), il rilevatore di attività vocale (VAD) deve verificare che chi parla abbia terminato la proposizione. Regolare la soglia di silenzio a fine frase su valori troppo ridotti spezza le naturali esitazioni in frammenti incomprensibili; impostarla su durate eccessive blocca il ritmo dello scambio.
La catena di latenza nella traduzione dal vivo analizzata fase per fase
Ogni enunciato catturato dall’array di microfoni beamforming attraversa cinque passaggi obbligati: framing uplink Bluetooth SCO/LE Audio, calcolo della finestra di silenzio VAD, generazione token ASR in streaming, riordino contestuale NMT e sintesi vocale tramite vocoder TTS. Se i tempi di rete via 5G o Wi-Fi si attestano normalmente tra 80 e 180 millisecondi, il timer VAD attende volutamente tra 500 e 1.200 millisecondi di silenzio acustico per confermare la conclusione del periodo.
Le lingue con verbo in posizione finale impongono al buffer di traduzione di trattenere i termini fino alla comparsa del predicato al termine della clausola. Anche quando l’ASR in streaming trascrive le parole sullo schermo dello smartphone in appena 300 millisecondi, il motore audio TTS posticipa la riproduzione sonora fino al completamento dell’ordine sintattico, evitando che la voce artificiale debba correggersi a metà discorso.
| Fase della pipeline | Intervallo tipico (ms) | Componente responsabile | Conseguenza di un taglio eccessivo | Strategia di ottimizzazione |
|---|---|---|---|---|
| Uplink microfono Bluetooth | 40 - 90 ms | SoC auricolari & stack host | Perdita di pacchetti in ambienti a 2,4 GHz saturi | Mantenere il telefono a meno di 50 cm senza ostacoli |
| Finestra silenzio VAD | 500 - 1.200 ms | Motore audio dell’app | Tronca le pause e spezza le proposizioni | Passare al rilascio tattile manuale push-to-talk |
| Decodifica ASR streaming | 180 - 350 ms | NPU smartphone o server cloud | Incremento di errori omofoni su nomi propri | Preimpostare il profilo tematico o dialettale |
| Sintesi NMT & TTS | 350 - 830 ms | Modello traduzione & vocoder | Timbro piatto ed emissione frammentata | Parlare per frasi brevi; velocità riproduzione a 1,15x |
In che modo le modalità d’uso gestiscono le pause ASR
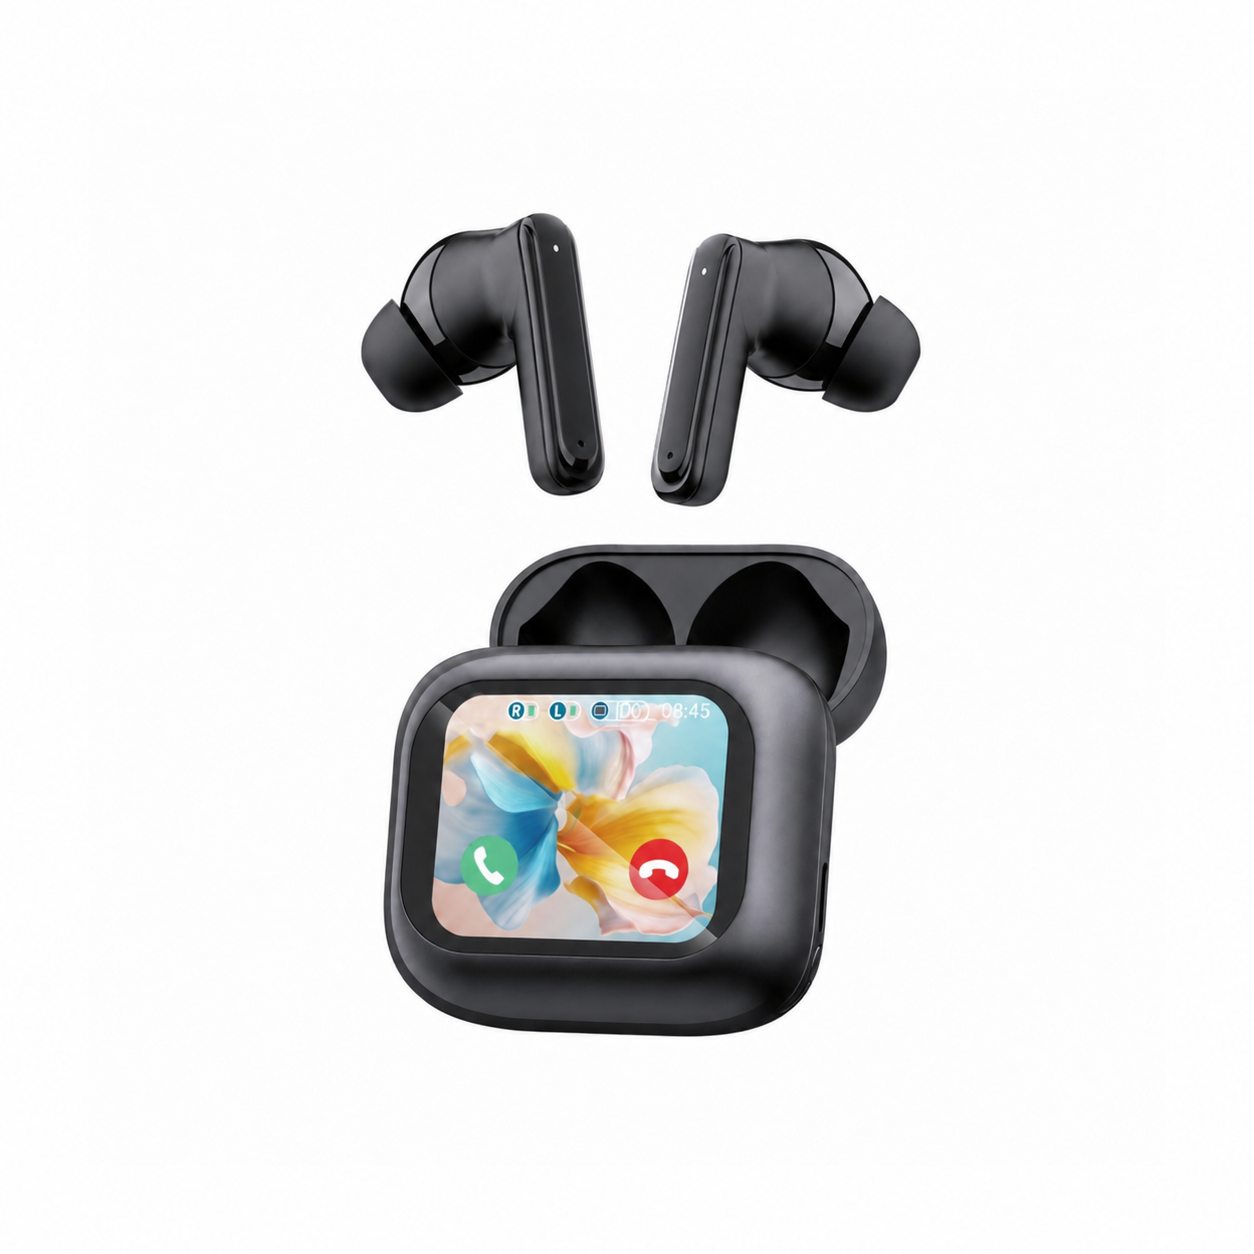
Poiché il rilevamento automatico delle pause incontra difficoltà negli ambienti riverberanti in cui il chiasso di un bar simula l’energia della voce, le applicazioni companion suddividono l’esperienza in modalità distinte. In modalità tocco (o Press-to-Talk), appoggiare e rilasciare lo stelo dell’auricolare chiude manualmente il buffer audio, cancellando gli 800 millisecondi di attesa del VAD e portando la latenza complessiva sotto 1,2 secondi.
Le modalità di conversazione libera e ascolto continuo si affidano totalmente alle soglie energetiche del VAD algoritmico e al filtraggio spaziale a doppio microfono. Per garantire continuità al flusso di traduzione durante spiegazioni articolate, chi parla dovrebbe inserire una pausa pulita di un secondo tra concetti completi anziché legare le frasi con intercalari come «ehm» o «quindi».
Far riposare le orecchie dopo ore di ascolto della voce sintetica TTS
Ascoltare a lungo voci sintetizzate compresse mentre si segue in contemporanea il discorso di un interlocutore reale in lingua straniera affatica la concentrazione ed esercita una pressione acustica costante sui medi dell’orecchio interno. Quando si rientra in hotel dopo una fitta giornata di incontri multilingue, i consueti auricolari sporgenti risultano fastidiosi e duri a contatto con il cuscino.
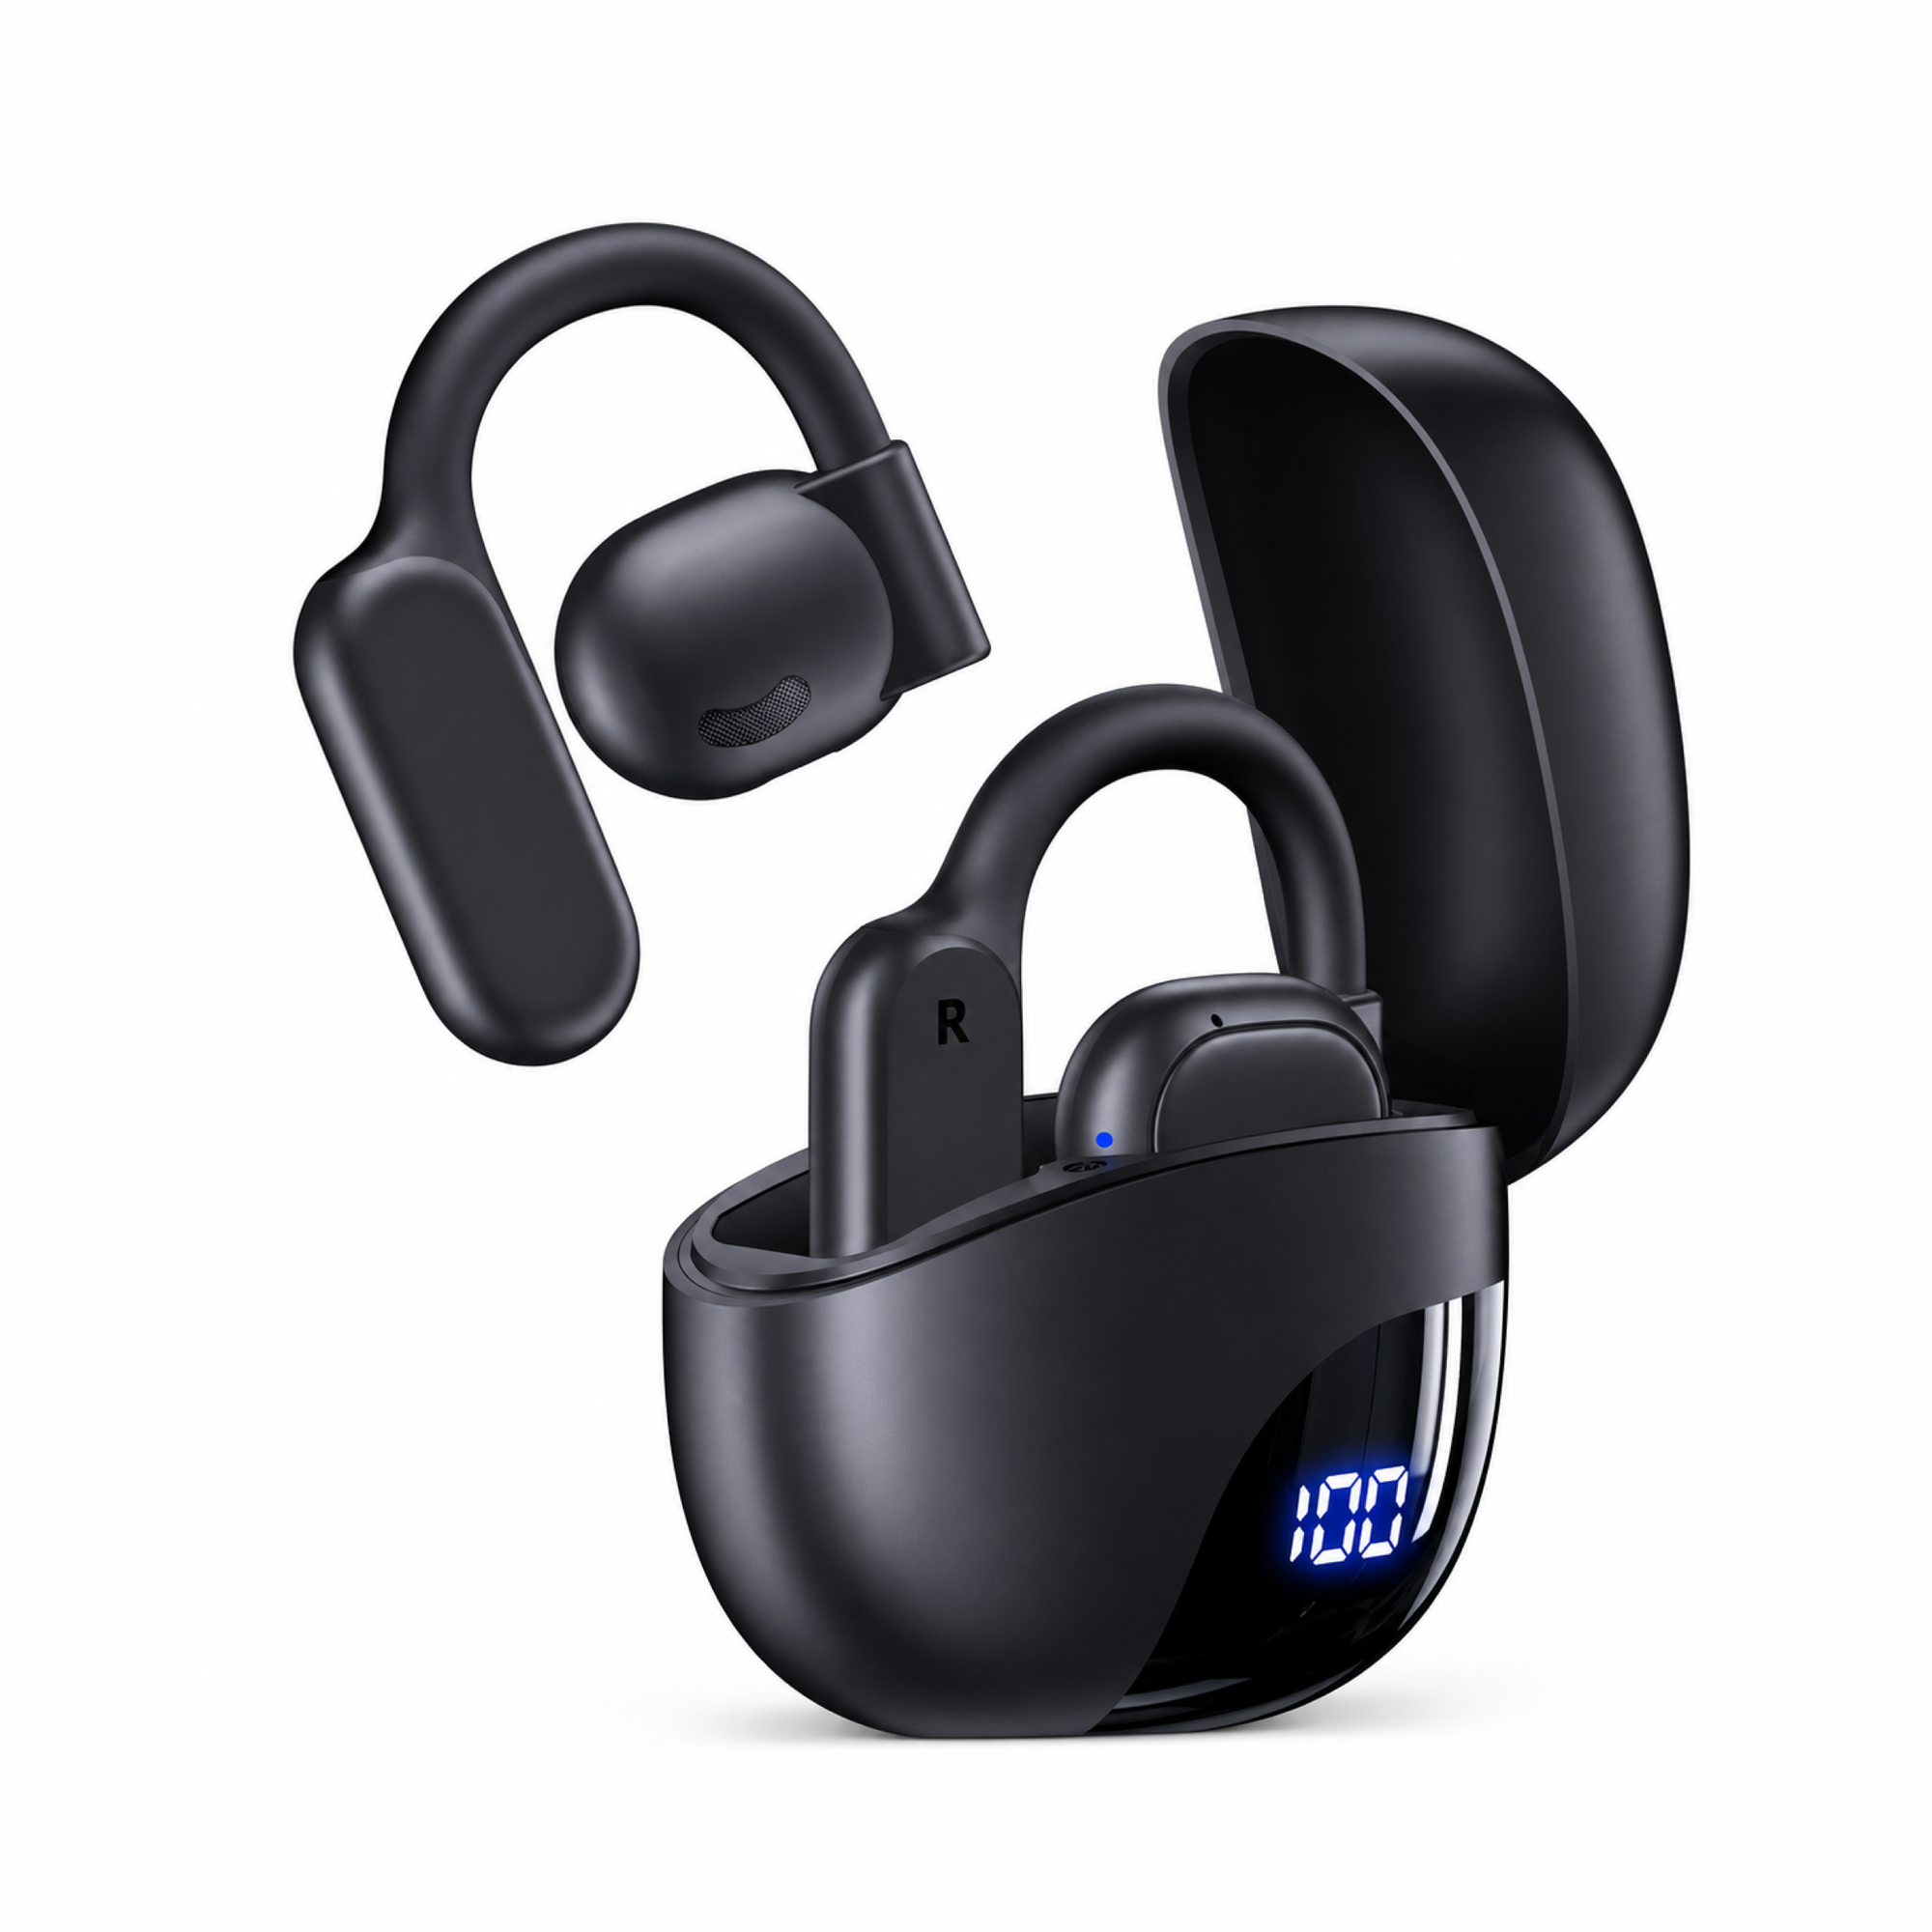
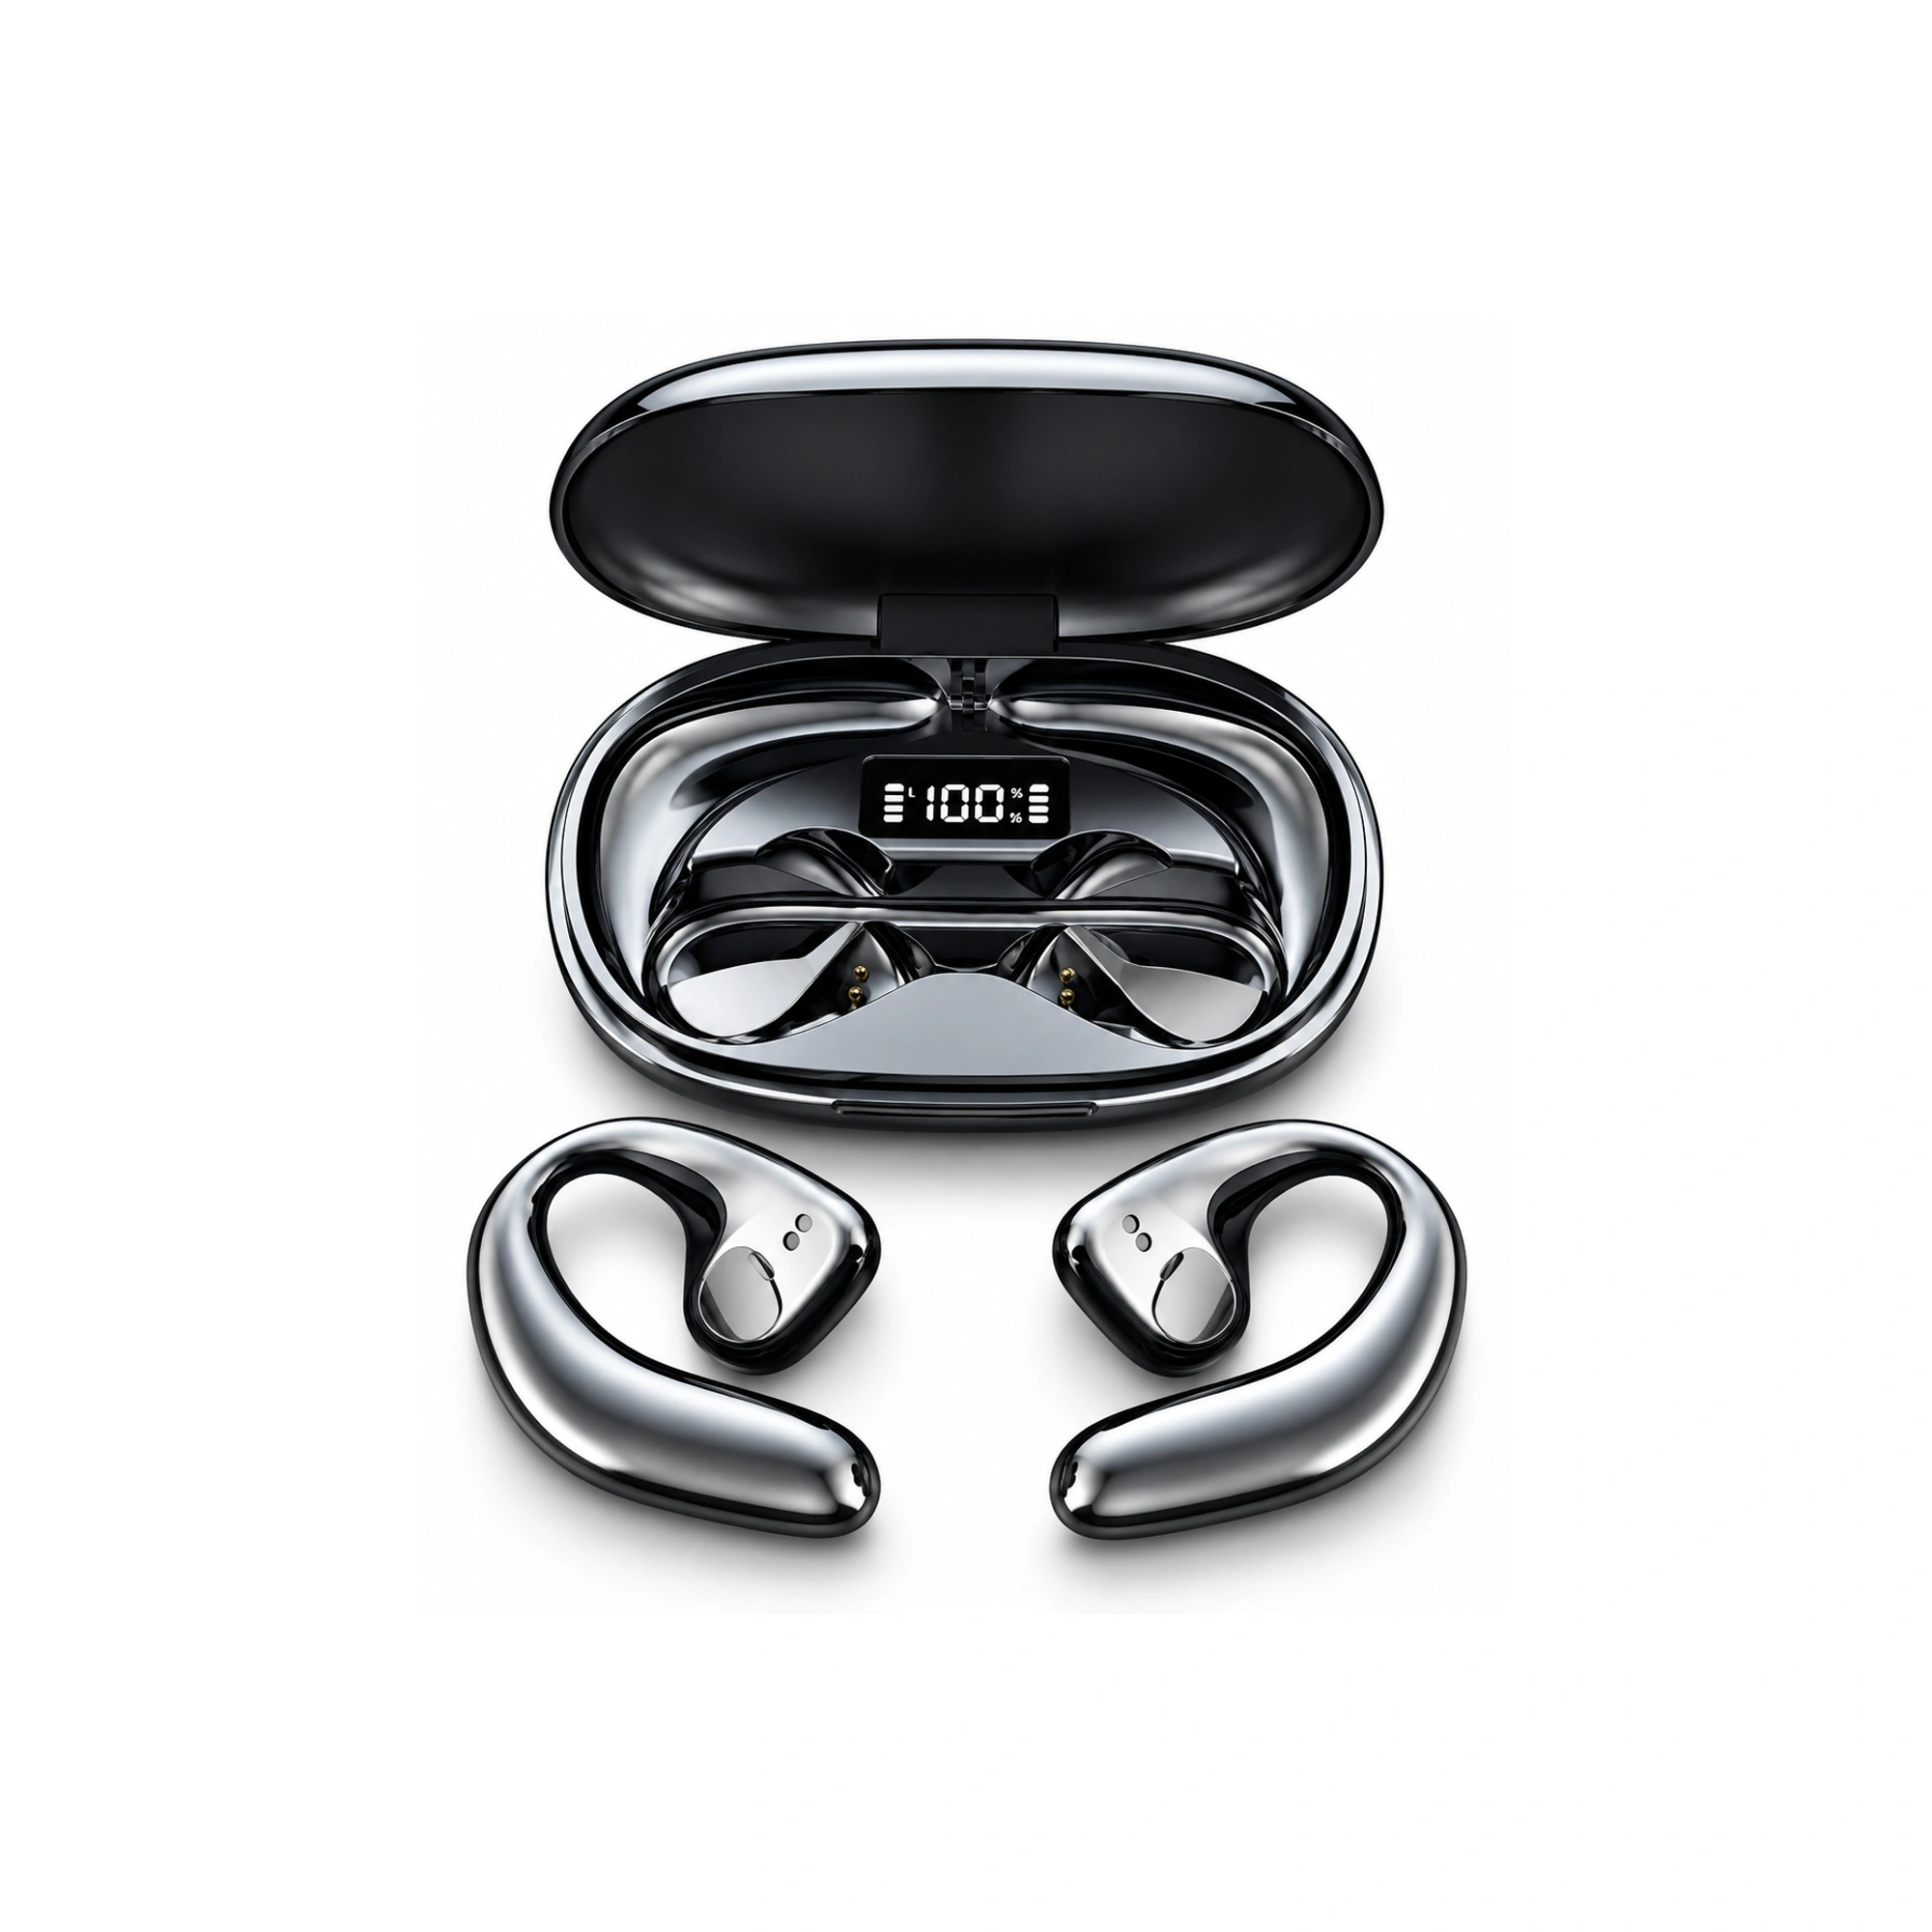
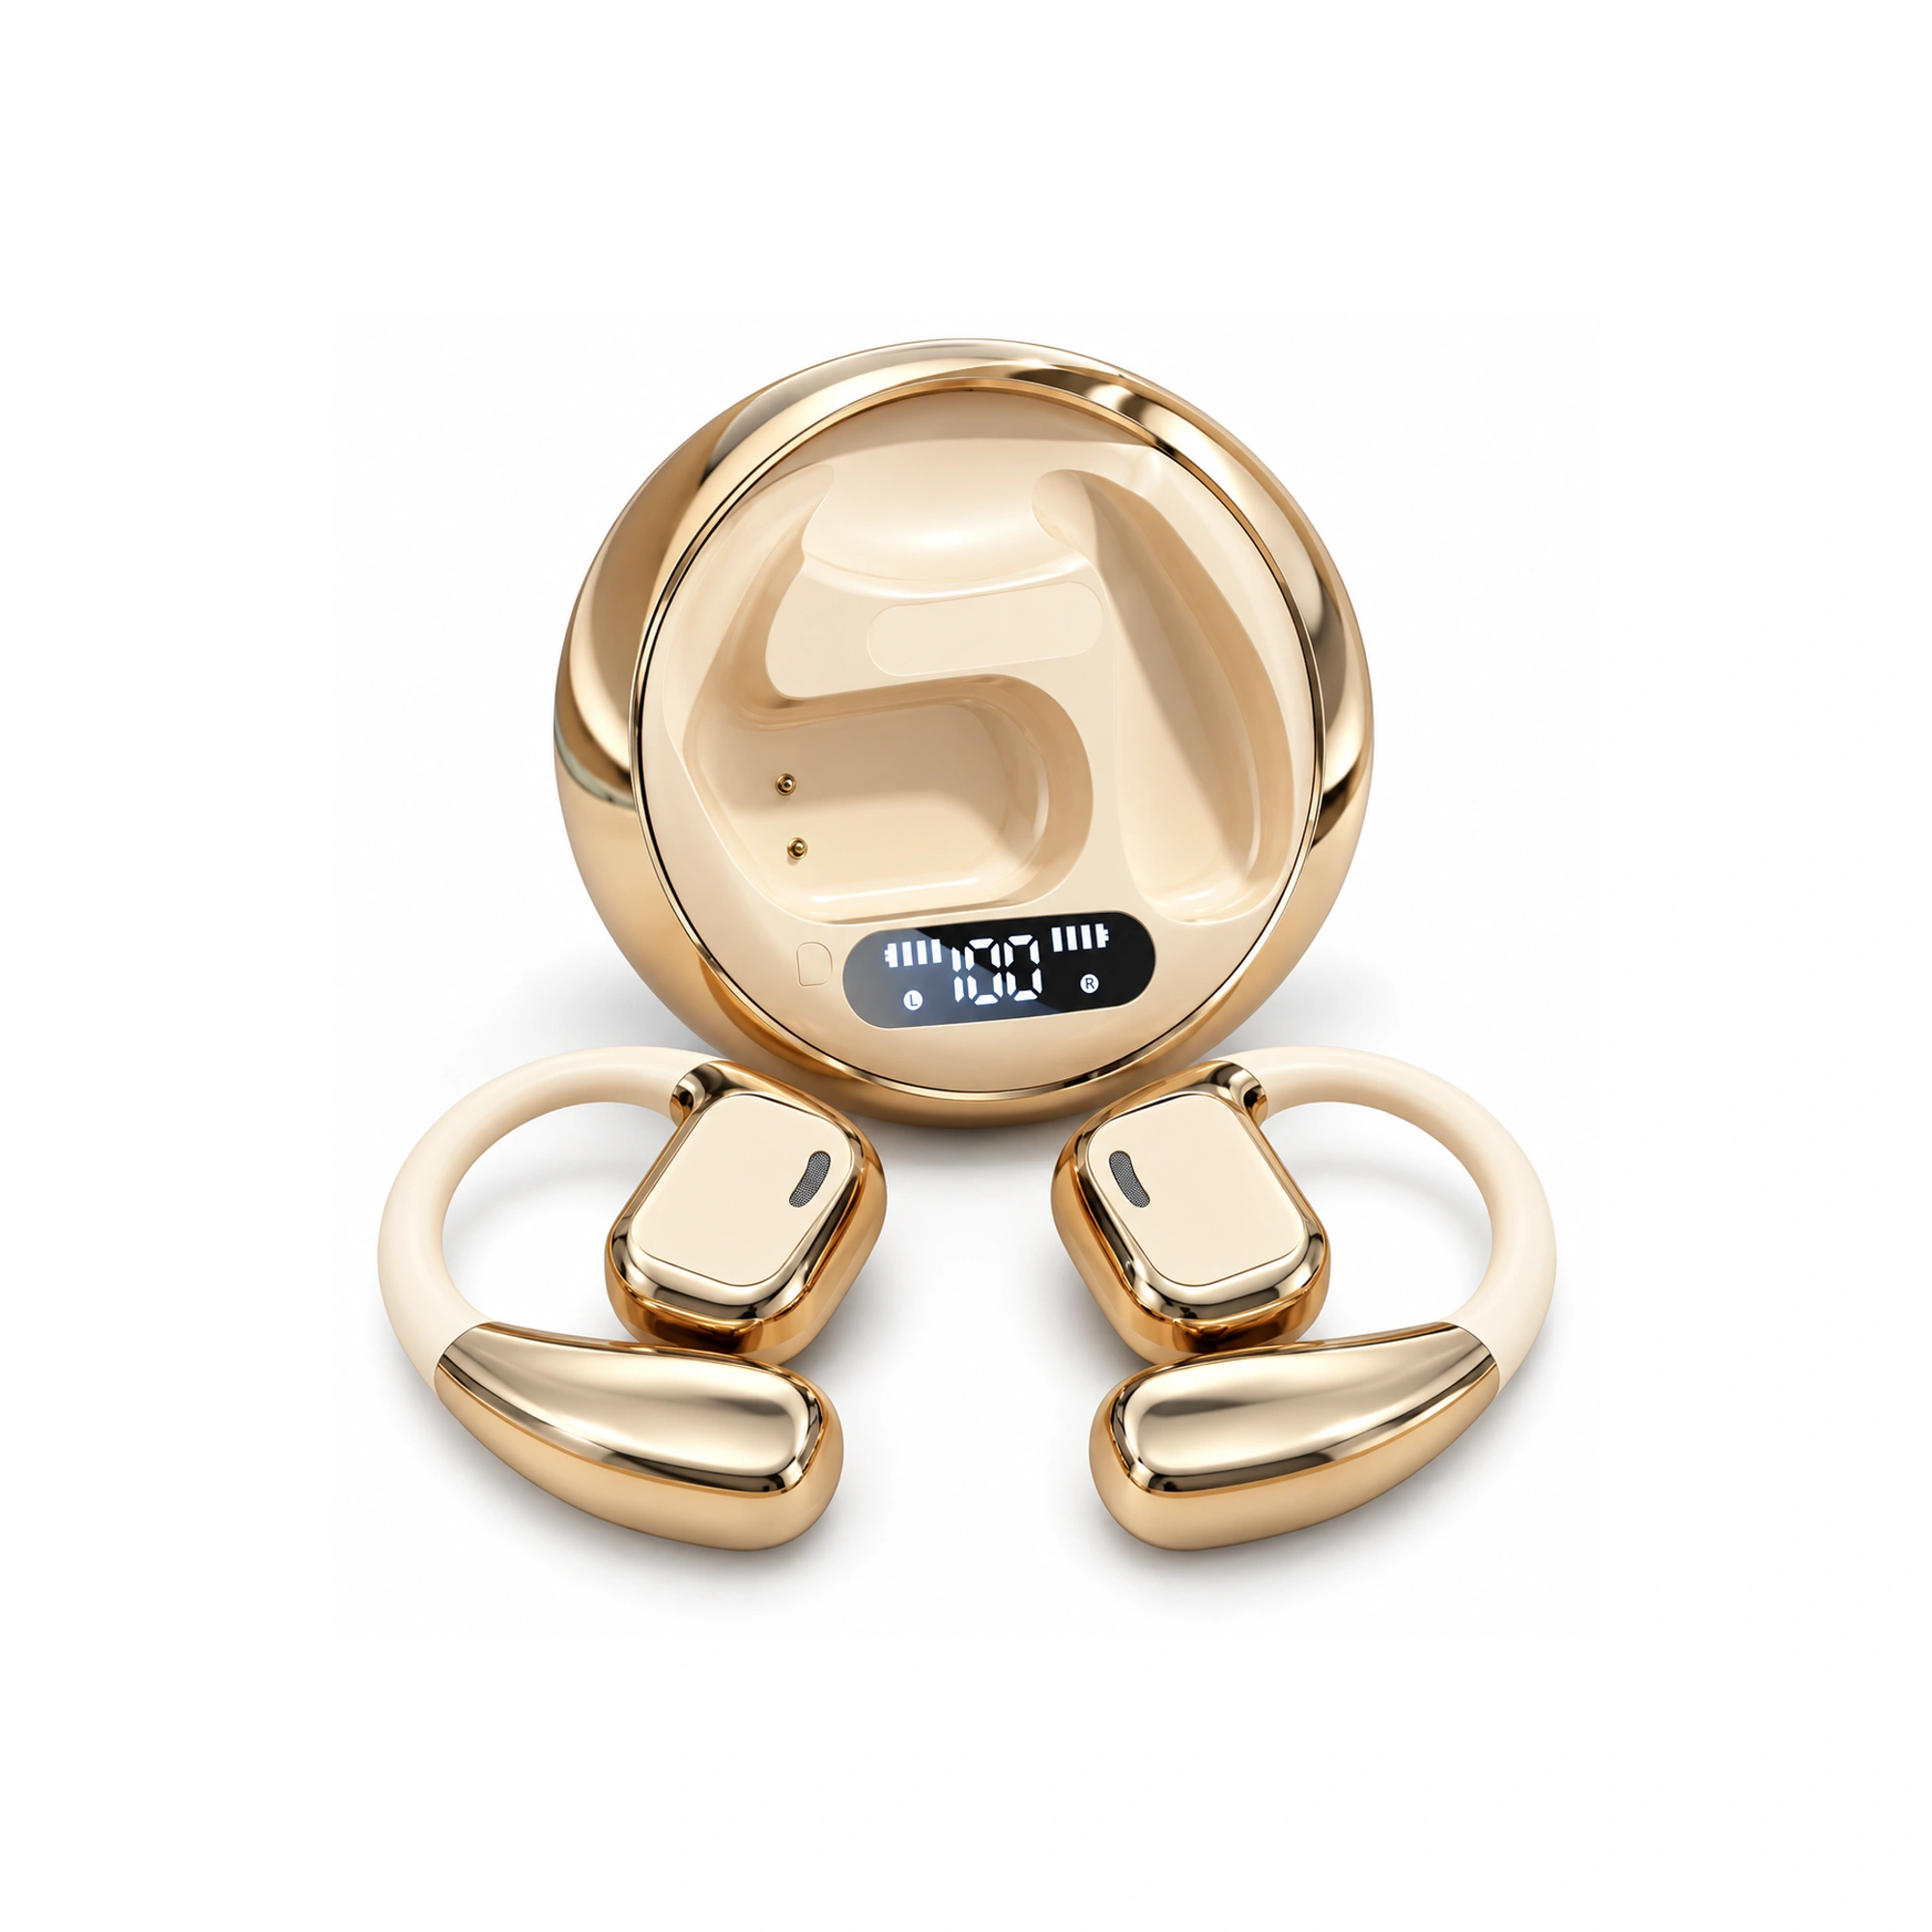
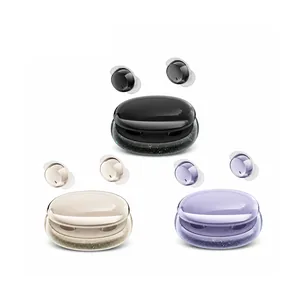
Flat, stemless earbuds for sleeping on your side, with a dynamic sleep-support mode and a starlight glow charging case. See the three colors at EARSOLE.
Sostituire gli auricolari di traduzione con IA con auricolari extra-piatti per dormire consente al padiglione e al condotto uditivo di distendersi senza subire pressioni laterali. Al posto delle frequenze vocali marcate, un sottofondo acustico delicato attenua i rumori del corridoio e agevola il recupero dell’udito durante il sonno.
Abitudini pratiche nel parlare per dimezzare il ritardo di traduzione
È possibile risparmiare quasi un secondo intero a ogni battuta regolando la struttura delle frasi e la distanza del microfono. Conviene articolare proposizioni affermative di dieci o quindici parole terminando con una pausa chiara, evitando congiunzioni sospese che inducono il buffer ASR a rimanere in attesa di ulteriori frammenti.
In contesti rumorosi oltre i 70 dBA, disattivate il VAD automatico a favore del controllo manuale da stelo o schermo e portate la velocità TTS a 1,15x, così che la voce tradotta termini prima del nuovo intervento dell’interlocutore. Se non avete copertura dati all’estero, approfondite la nostra guida tecnica agli auricolari di traduzione offline e ai pacchetti lingua per NPU locale.
Domande frequenti
Perché il testo tradotto compare sullo smartphone prima che l’audio arrivi agli auricolari?
L’ASR in streaming genera ipotesi testuali mentre parlate, ma i sistemi di traduzione neurale e sintesi TTS devono attendere la conclusione della frase per riordinare i verbi e generare un’intonazione naturale prima di inviare l’audio agli auricolari.
Il Bluetooth 5.3 o 5.4 elimina la latenza negli auricolari per la traduzione in tempo reale?
Le nuove versioni del Bluetooth migliorano l’efficienza energetica e la stabilità del segnale, ma sottraggono solo poche decine di millisecondi alla trasmissione radio; la maggior parte del ritardo deriva dalla memorizzazione temporanea della proposizione e dai timer di silenzio del VAD.