

Echtzeit-Übersetzungs-Ohrhörer und ASR-Pausenlatenz am Satzende bei Live-Gesprächen
Marketing-Demos für Echtzeit-Übersetzungs-Ohrhörer suggerieren oft eine sofortige Synchronisation, doch wer sie an einem lauten Bahnhof in Tokio oder auf einem Messestand in Mailand nutzt, bemerkt eine deutliche Pause von zwei bis vier Sekunden vor der Audioausgabe im Ohr. Diese Verzögerung entsteht selten durch langsame Bluetooth-Verbindungen oder träge Cloud-Server; der eigentliche Engpass liegt in der Erkennung linguistischer und akustischer Grenzen innerhalb der automatischen Spracherkennung (ASR).
Bevor ein neuronales Übersetzungsmodell einen gesprochenen Satz zwischen Sprachen mit unterschiedlicher Wortstellung übersetzen kann (etwa vom japanischen Subjekt-Objekt-Verb ins englische Subjekt-Verb-Objekt), muss die Sprachaktivitätserkennung (VAD) das Ende des Nebensatzes bestätigen. Wird die Stille-Schwelle am Satzende zu kurz eingestellt, zerhacken kurze Sprechpausen den Satz in unvollständige Bruchstücke; ist sie zu lang gewählt, gerät der natürliche Gesprächsfluss ins Stocken.
Die Latenzkette der Live-Übersetzung im Detail
Jede Äußerung, die über das Beamforming-Mikrofonarray der Ohrhörer erfasst wird, durchläuft fünf Abschnitte: Bluetooth SCO/LE Audio Framing, VAD-Stillefensterung, Streaming-ASR-Token-Generierung, neuronale NMT-Kontextumordnung und TTS-Vocoder-Synthese. Während die reine Netzwerklaufzeit über 5G oder WLAN meist zwischen 80 und 180 Millisekunden liegt, wartet der VAD-Timer gezielt 500 bis 1.200 Millisekunden auf akustische Stille, um eine sichere Satzgrenze zu markieren.
Sprachen mit Verb-Letztstellung zwingen den Übersetzungspuffer dazu, Wörter zwischenzuspeichern, bis das Prädikat am Satzende eintrifft. Selbst wenn Streaming-ASR Wörter innerhalb von 300 Millisekunden auf das Smartphone-Display bringt, hält die TTS-Audio-Engine die Sprachwiedergabe zurück, bis die Satzstruktur geklärt ist, damit die künstliche Stimme mitten im Satz nicht korrigieren muss.
| Pipeline-Abschnitt | Typischer Zeitbedarf (ms) | Steuernde Komponente | Auswirkung zu aggressiver Kürzung | Optimierungsstrategie |
|---|---|---|---|---|
| Bluetooth-Uplink | 40 - 90 ms | Ohrhörer-SoC & Host-Stack | Paketverlust in überfüllten 2,4-GHz-Netzen | Smartphone im Abstand von unter 50 cm halten |
| VAD-Pausenstille | 500 - 1.200 ms | Begleit-App-Audio-Engine | Schneidet natürliche Pausen ab und teilt Sätze | Manuelle Touch-to-Speak-Auslösung nutzen |
| Streaming-ASR-Dekodierung | 180 - 350 ms | Cloud oder Smartphone-NPU | Höhere Fehlerquote bei Eigennamen | Passendes Fachgebiet oder Dialektprofil wählen |
| NMT- & TTS-Synthese | 350 - 830 ms | Übersetzungsmodell & Vocoder | Monotone Sprachmelodie und abgehackte Worte | In kurzen Sätzen sprechen; Tempo auf 1,15x stellen |
Wie Gesprächsmodi das ASR-Timing steuern
Da automatische Pausenerkennung in halligen Räumen oder lauten Cafés leicht Nebengeräusche mit menschlicher Stimme verwechselt, teilen Begleit-Apps die Übersetzung in getrennte Interaktionsmodi auf. Im Touch-Modus (oder Push-to-Talk) schließt das Berühren und Loslassen des Ohrhörerstegs den Audiopuffer sofort manuell. Das spart das 800-Millisekunden-VAD-Wartefenster ein und senkt die Gesamtreaktionszeit auf unter 1,2 Sekunden.
Der freie Gesprächsmodus und das Simultan-Mithören verlassen sich vollständig auf algorithmische VAD-Schwellenwerte und Beamforming zweier Mikrofone. Um den Übersetzungsfluss bei längeren Vorträgen oder komplexeren Schilderungen stabil zu halten, sollten Sprechende zwischen Gedankengängen eine klare Atempause einlegen, anstatt Sätze endlos mit Füllwörtern wie „äh“ oder „also“ aneinanderzureihen.
Erholung für die Ohren nach Stunden mit synthetischer TTS-Sprache
Stundenlang komprimierten Text-to-Speech-Stimmen zu lauschen und parallel einem Gesprächspartner in einer Fremdsprache zu folgen, erfordert enorme Konzentration und erzeugt konstanten Schalldruck im Mitteltonbereich. Wenn man nach einem langen Konferenztag ins Hotelzimmer zurückkehrt, drücken herkömmliche, hervorstehende Ohrhörer unangenehm hart gegen das Kissen.
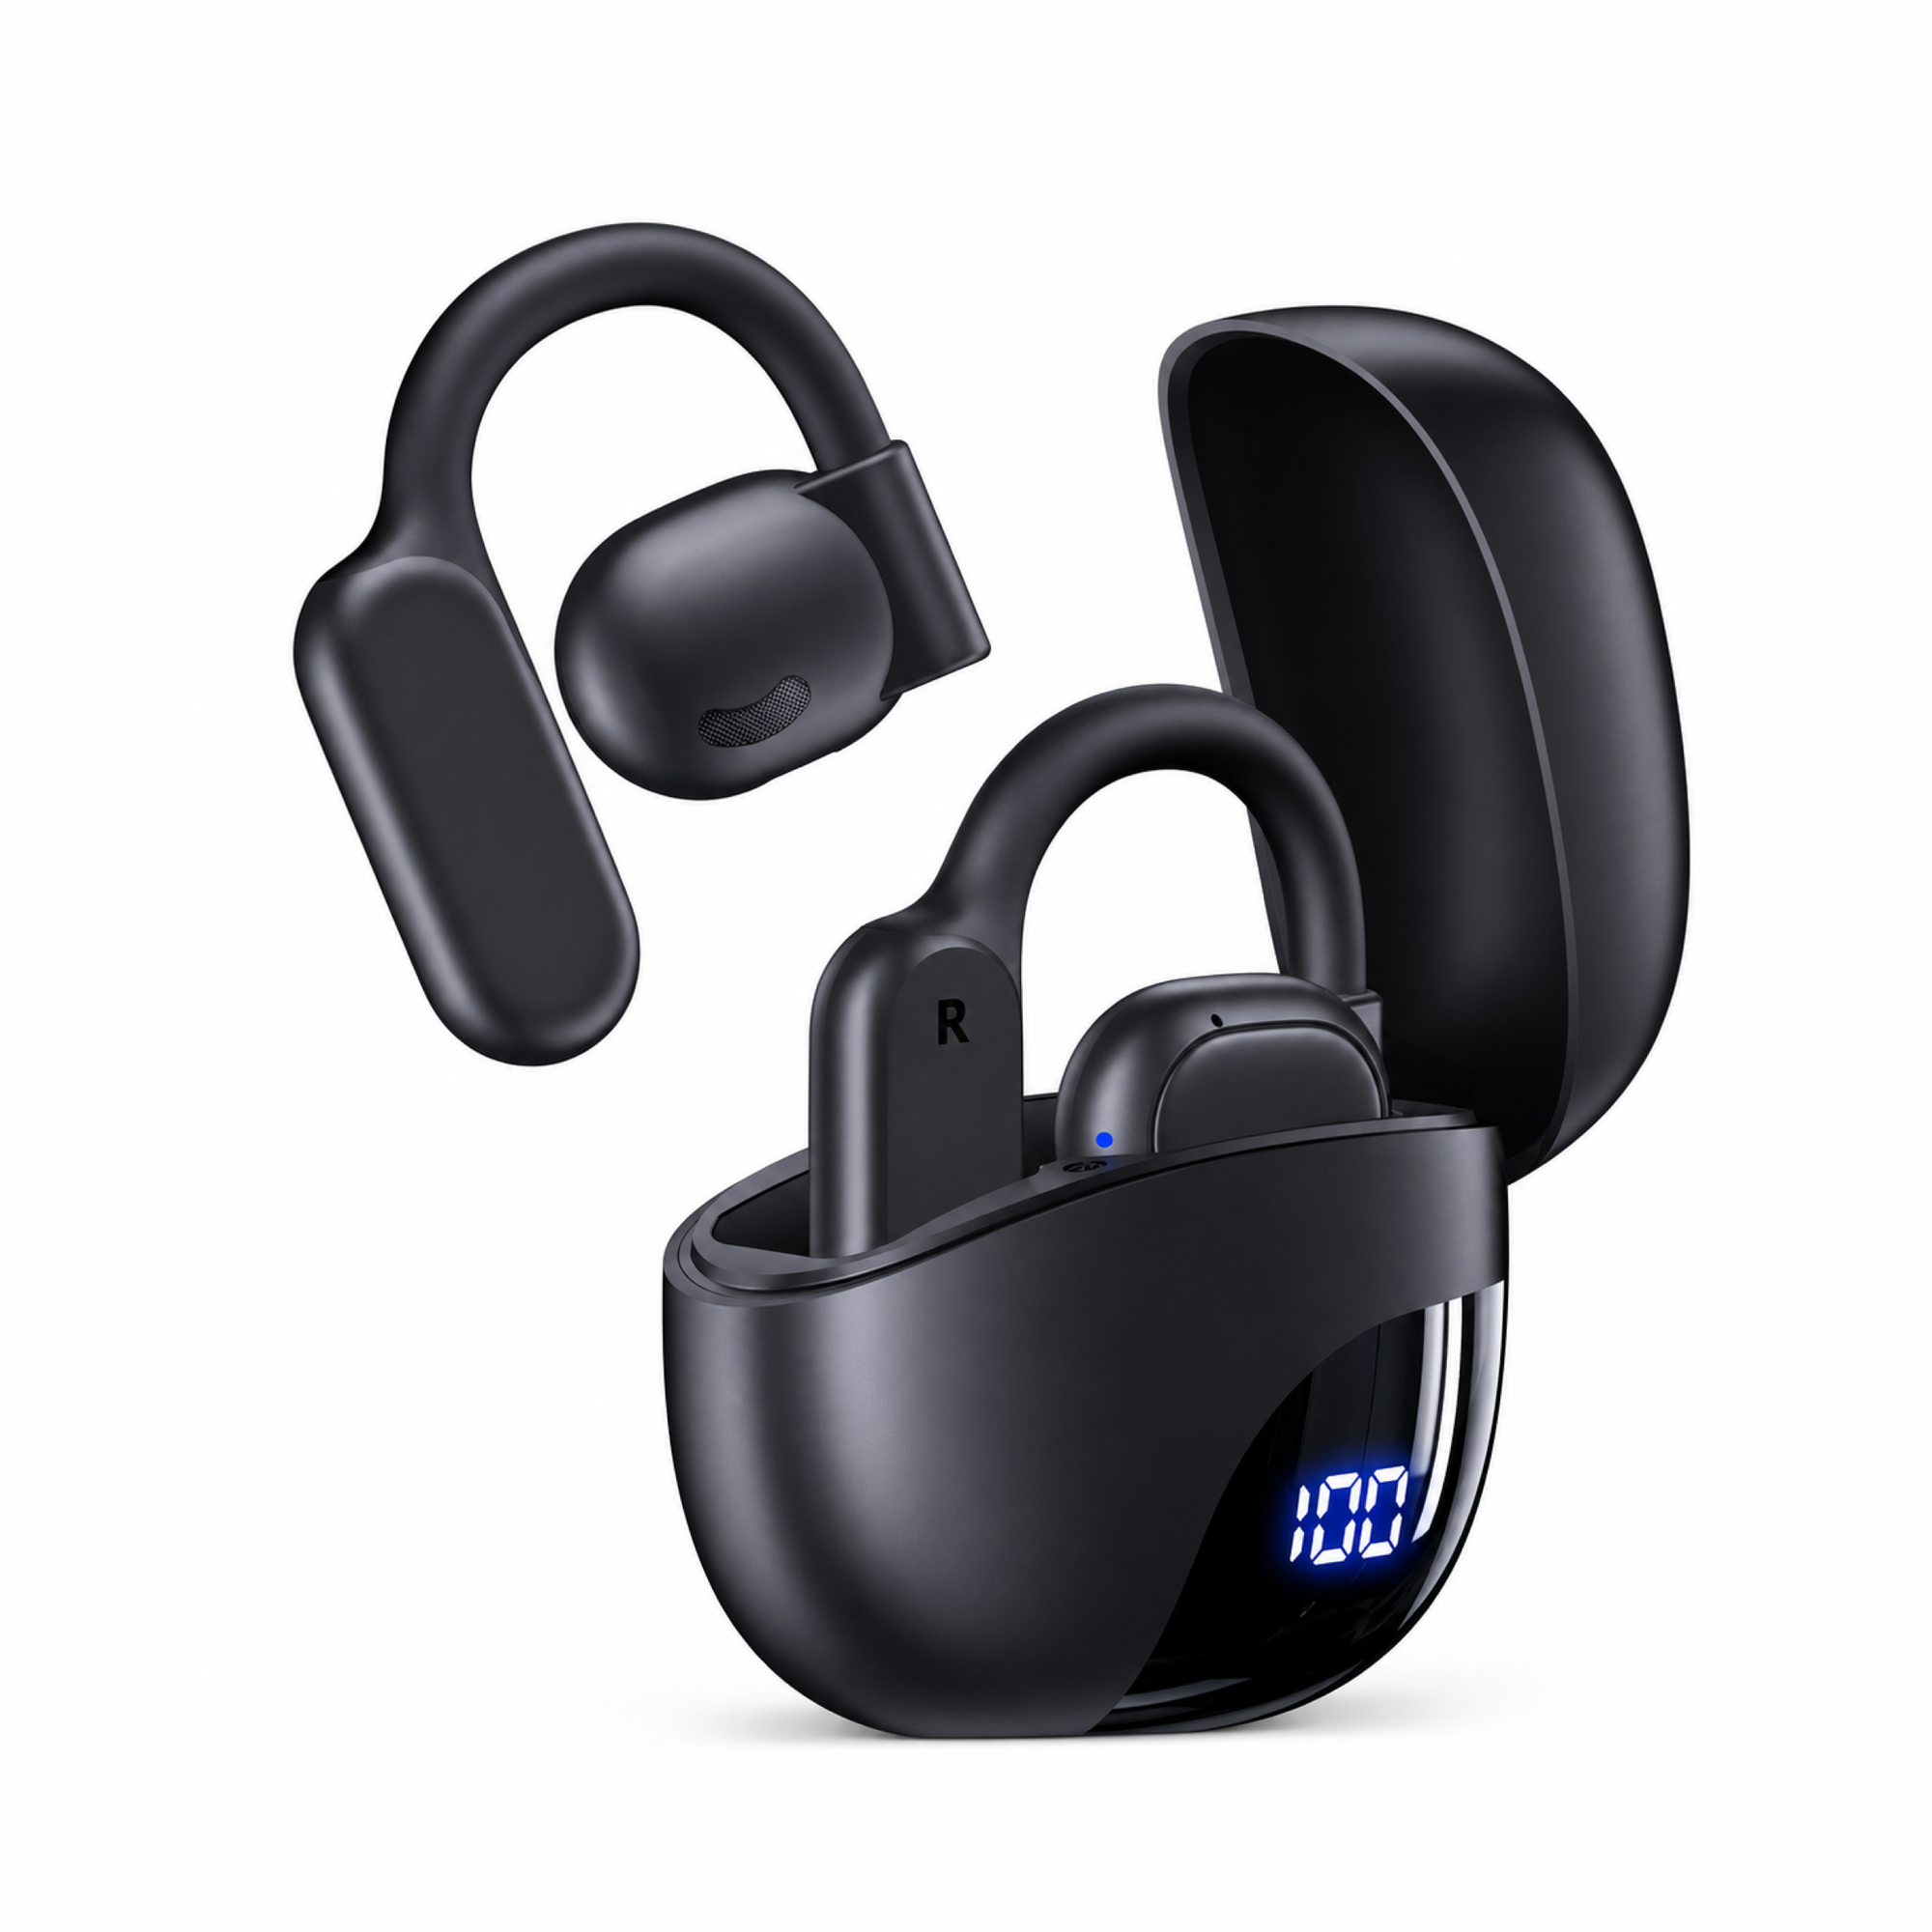
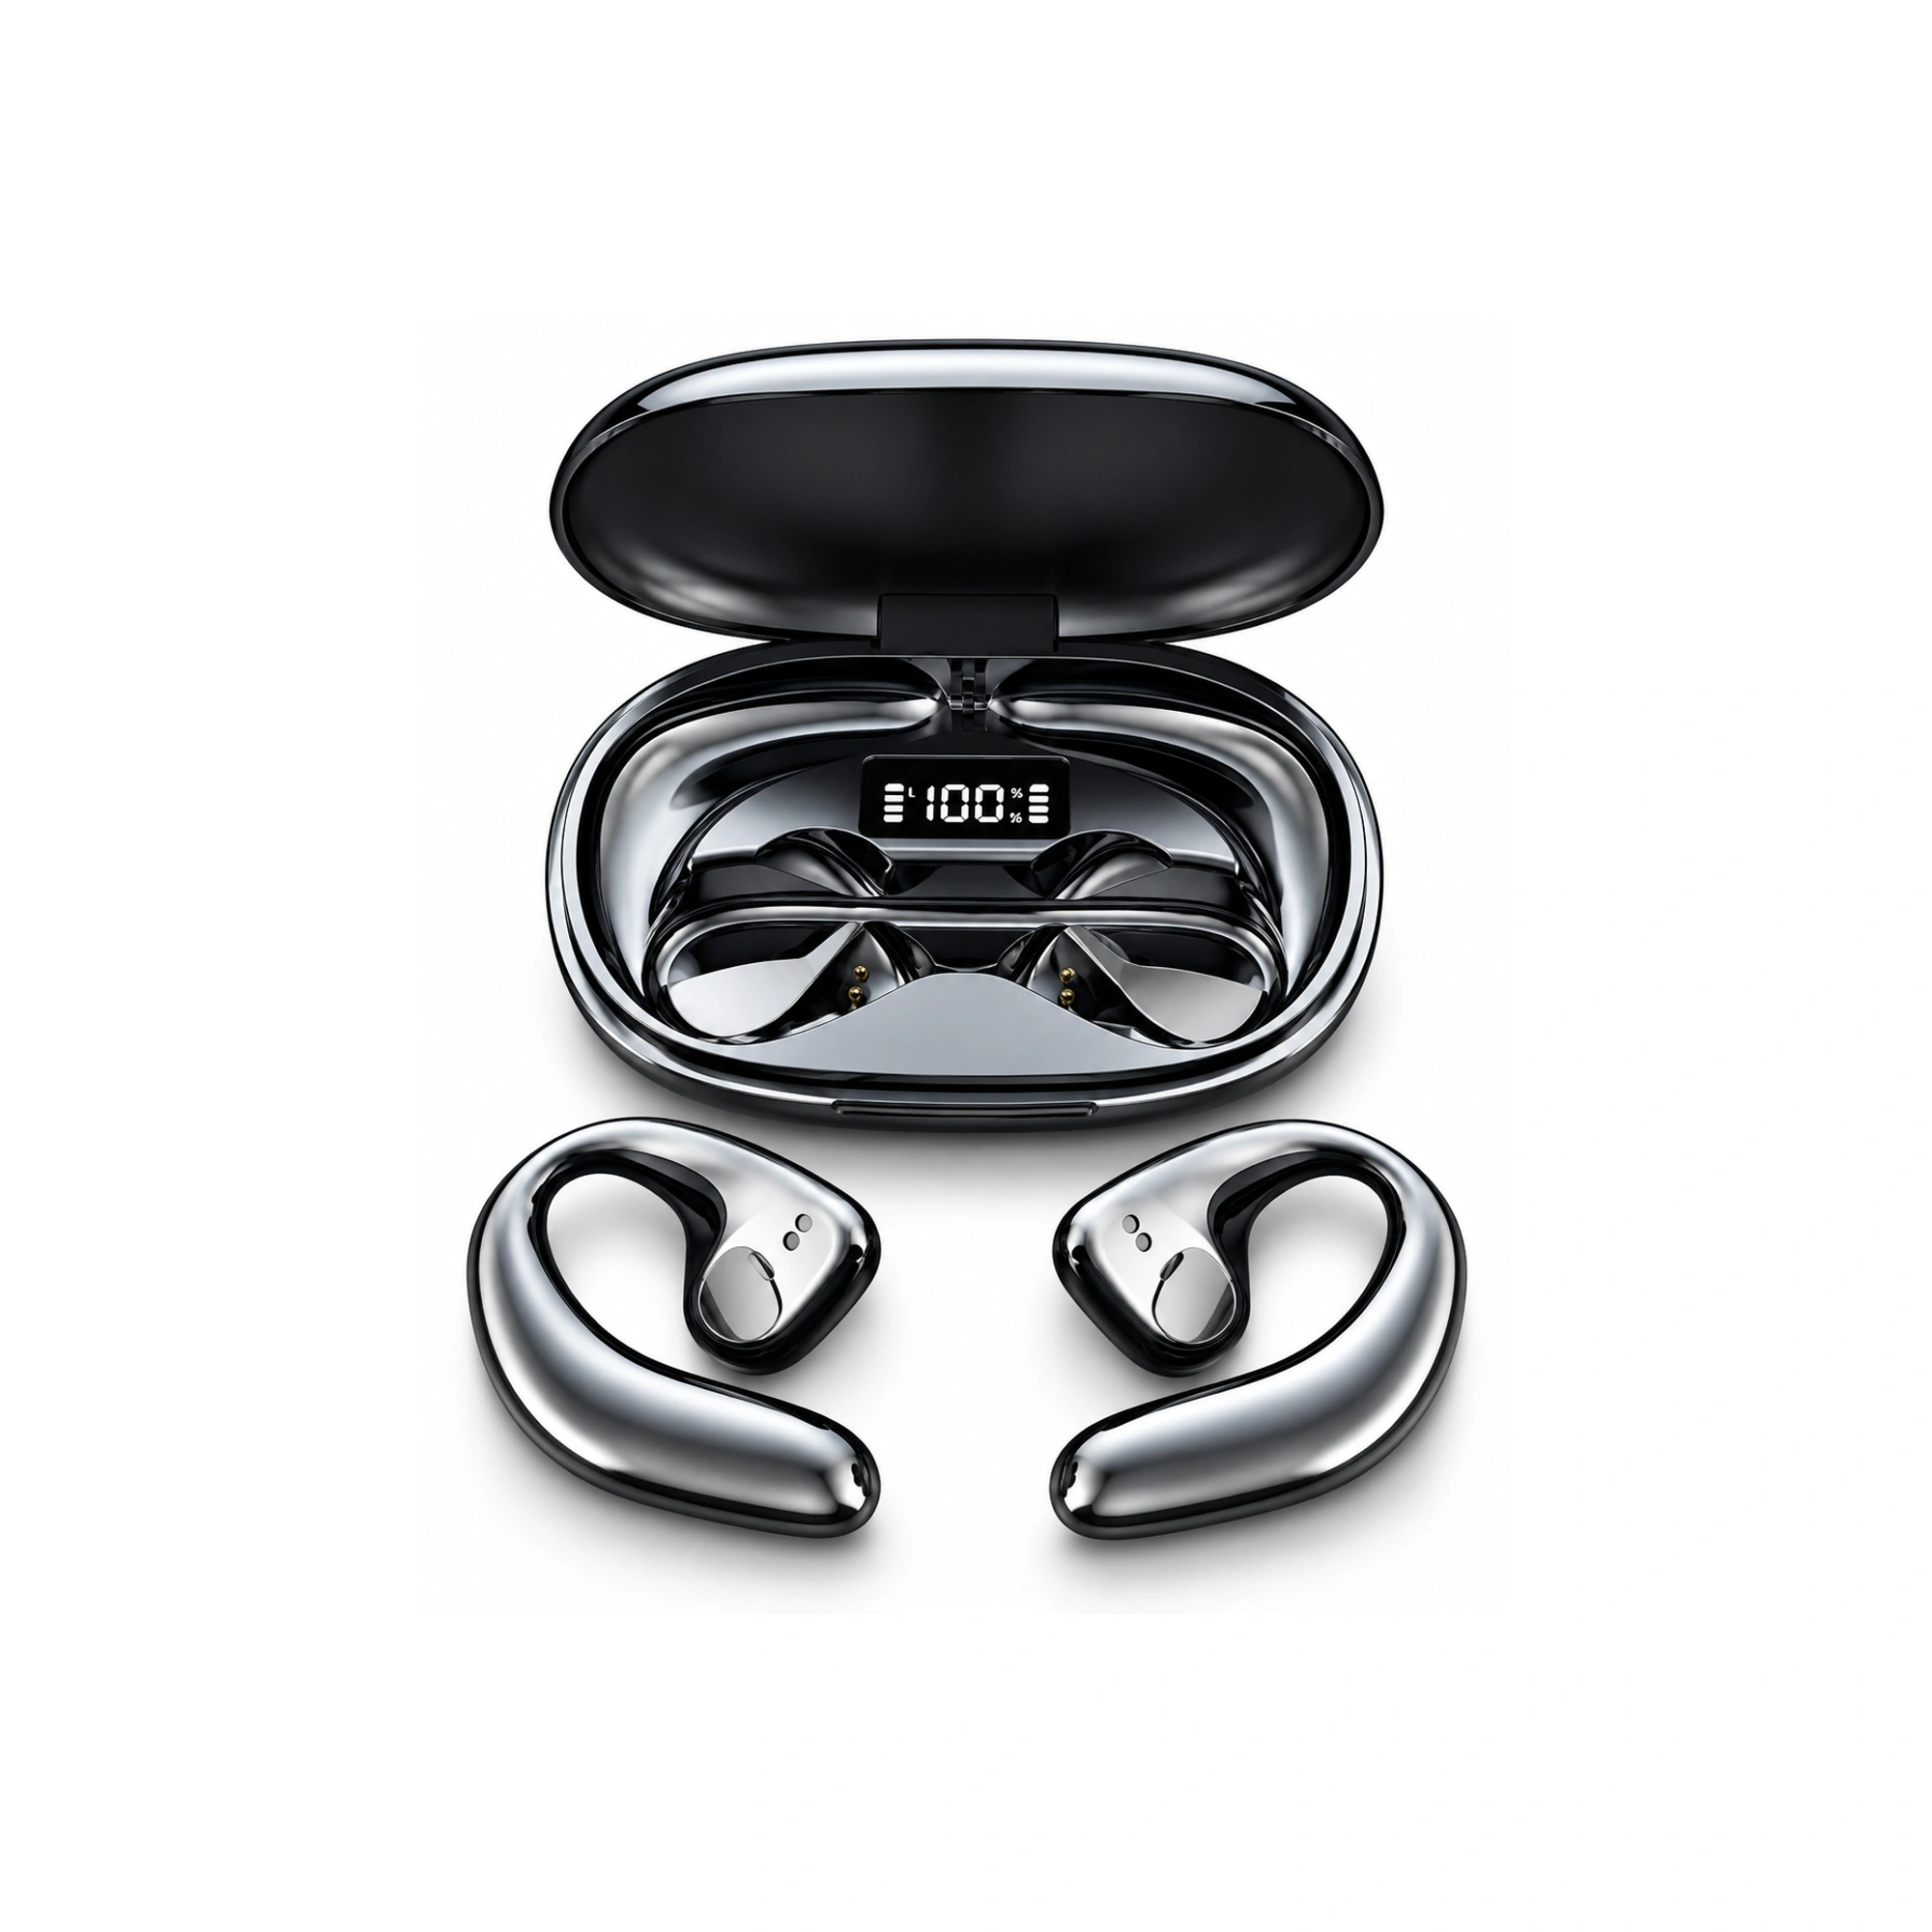
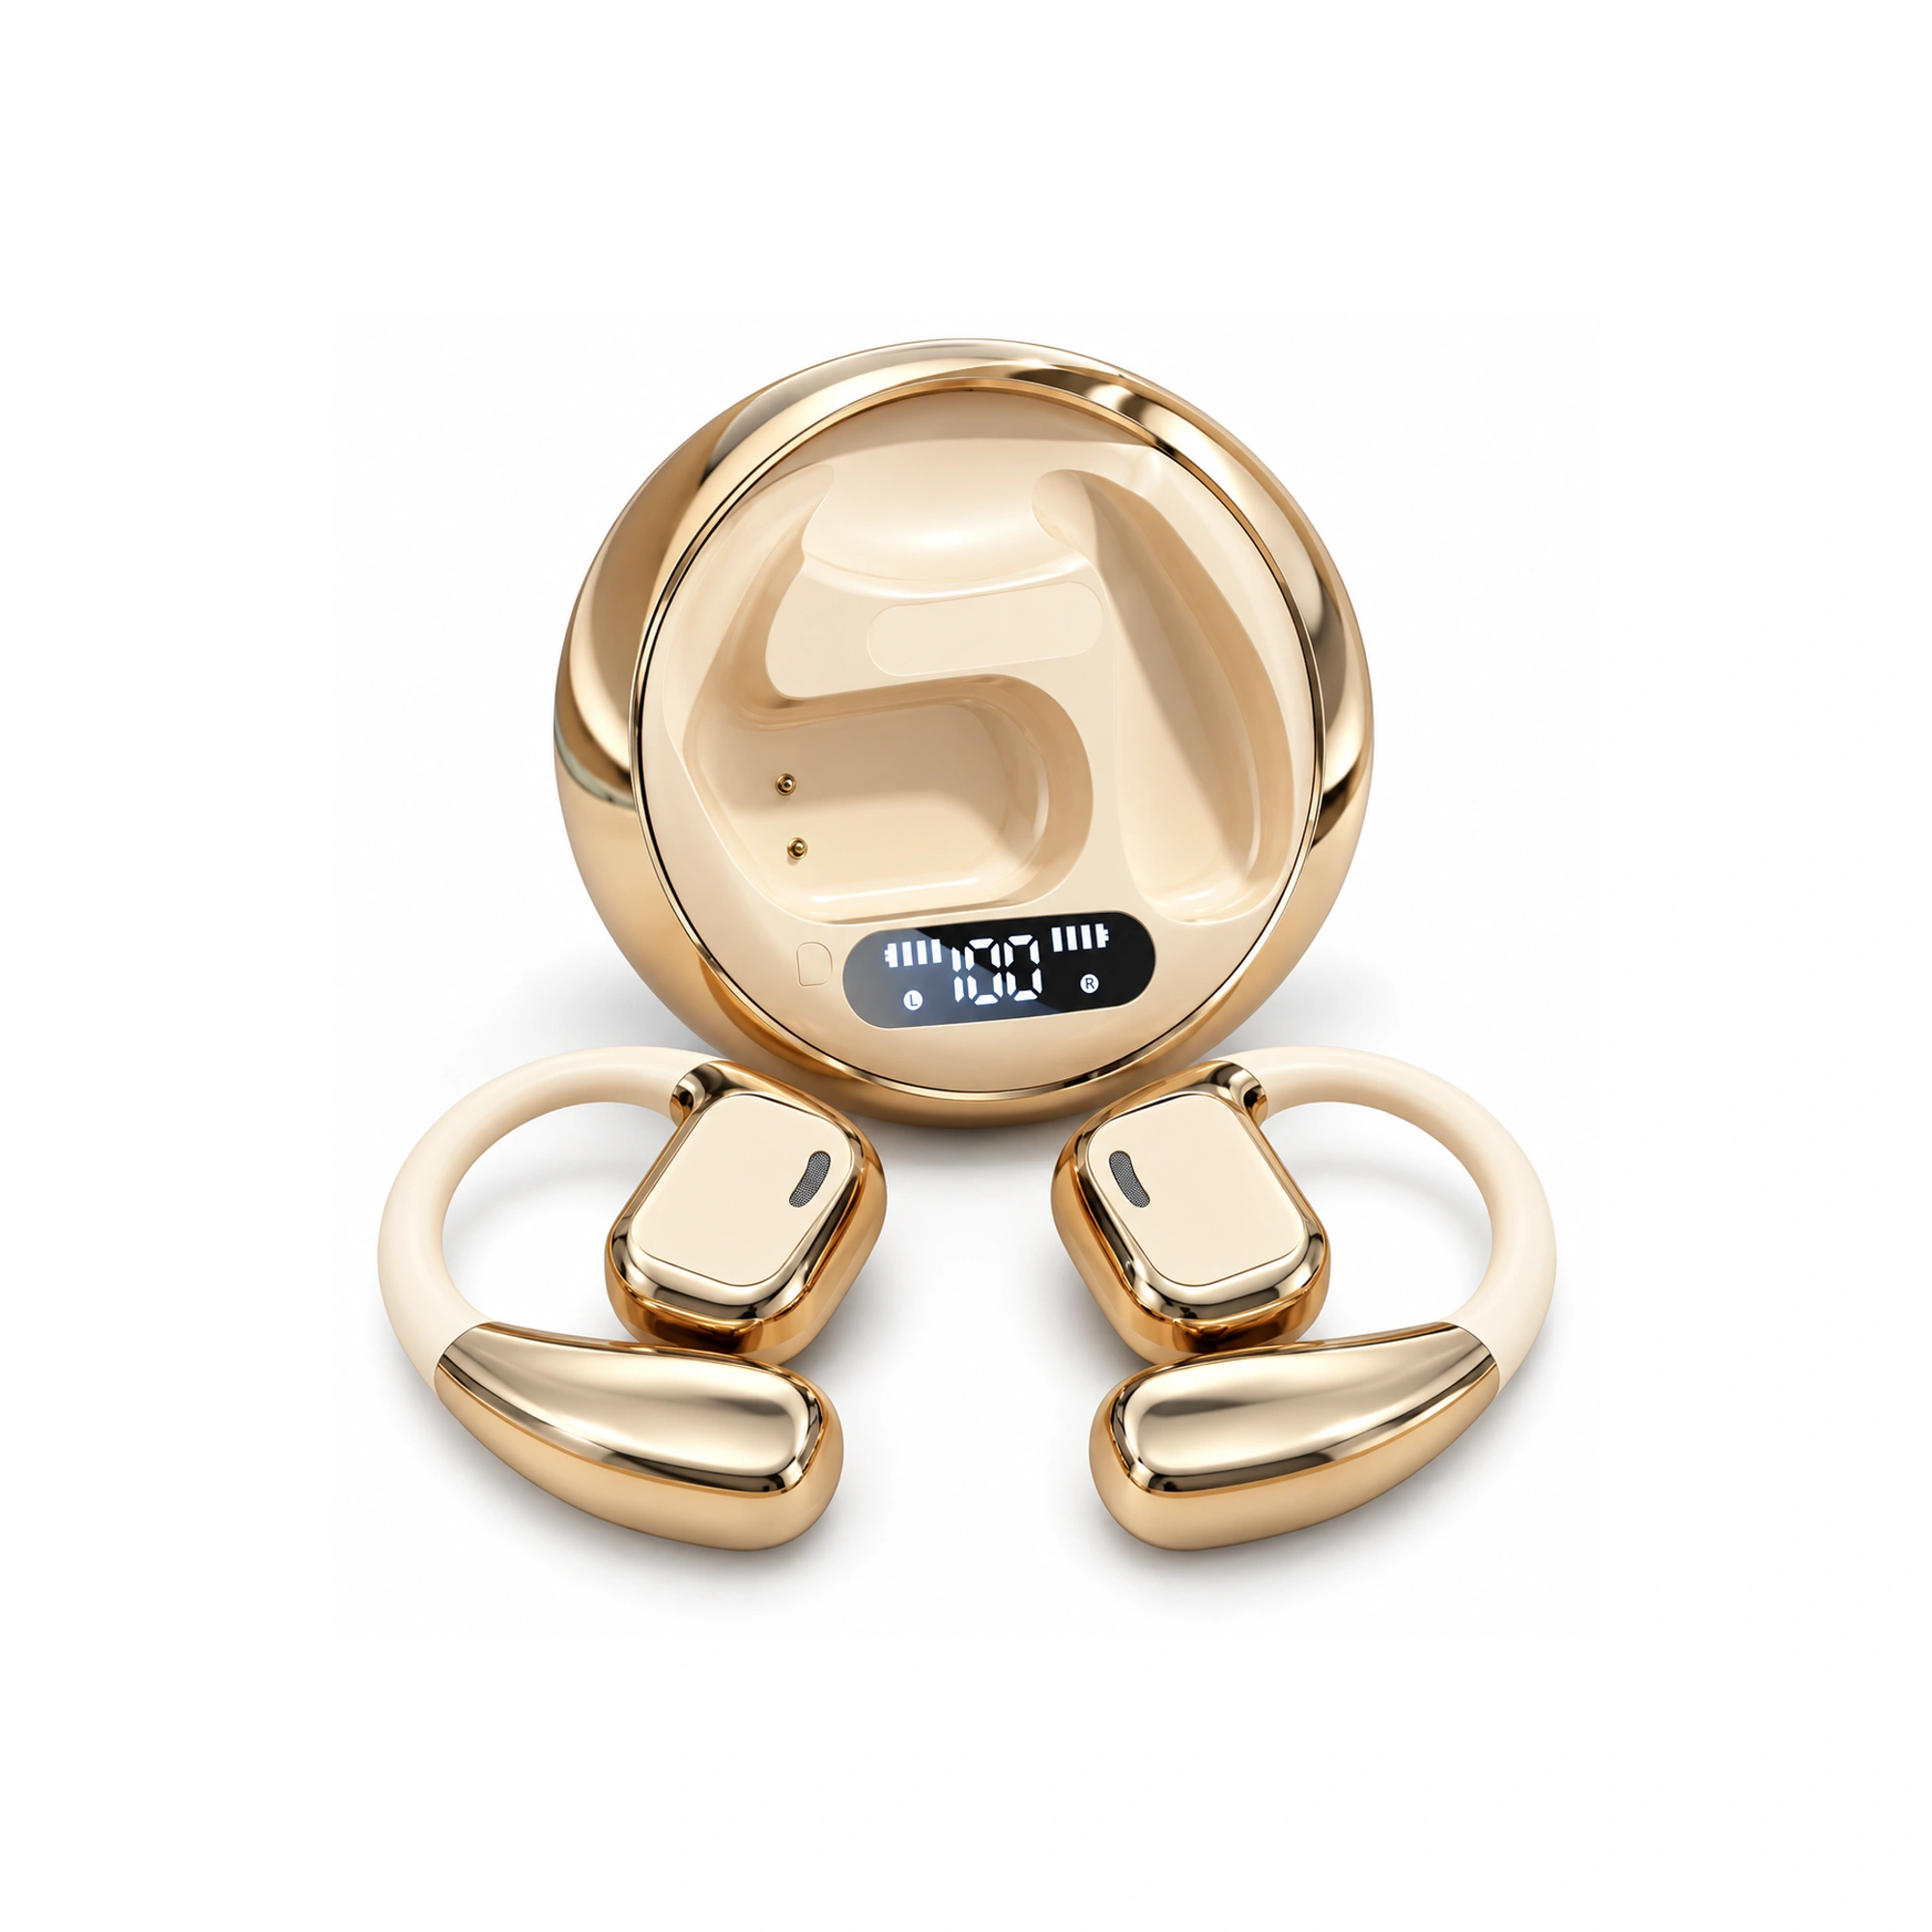
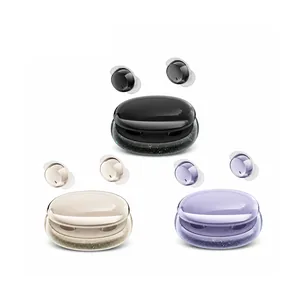
Flat, stemless earbuds for sleeping on your side, with a dynamic sleep-support mode and a starlight glow charging case. See the three colors at EARSOLE.
Der Wechsel von KI-Übersetzungs-Ohrhörern zu extrem flachen Schlaf-Ohrhörern entlastet Ohrmuschel und Gehörgang vom seitlichen Kissendruck. Statt harter Sprachfrequenzen dämpfen sanfte Klanglandschaften das nächtliche Flurgemurmel ab und helfen dem Gehör, sich über Nacht vollständig zu regenerieren.
Praktische Sprechgewohnheiten für halbierte Übersetzungslatenz
Nahezu eine ganze Sekunde pro Gesprächswechsel lässt sich sparen, indem man Satzlänge und Mikrofonabstand bewusst kontrolliert. Formulieren Sie prägnante Aussagesätze mit zehn bis fünfzehn Wörtern und setzen Sie einen deutlichen Schlusspunkt, statt Sätze mit verbindenden Konjunktionen offen zu halten, die den ASR-Puffer zum Weitersuchen verleiten.
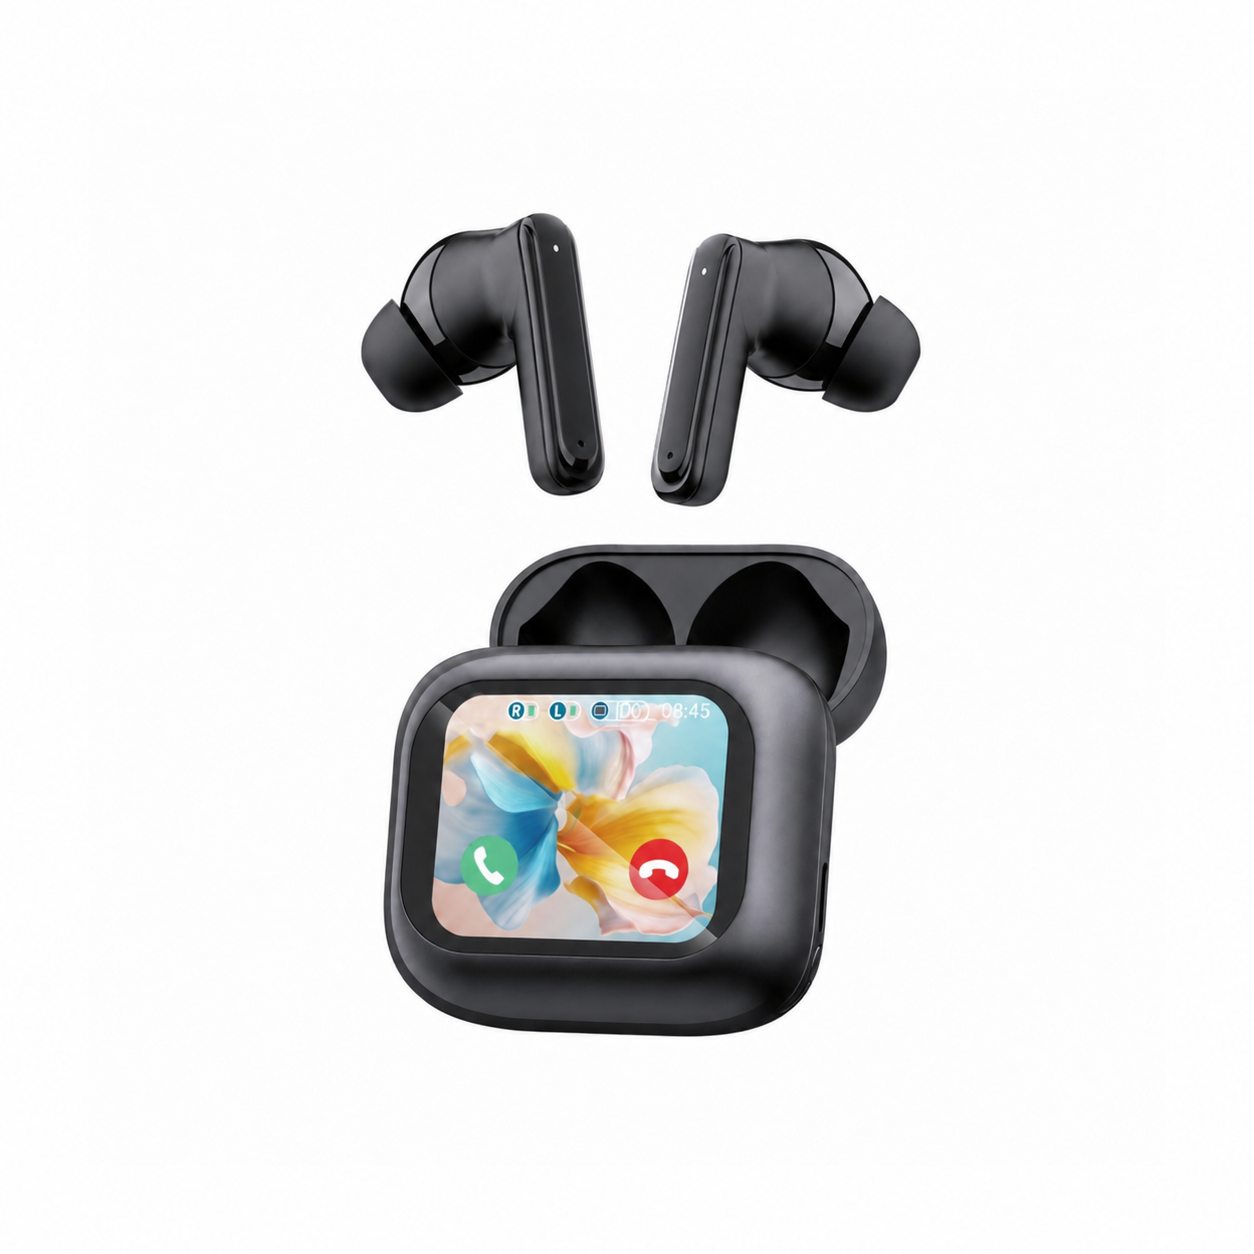
Schalten Sie in lauten Umgebungen über 70 dBA von der automatischen VAD-Erkennung auf die manuelle Touch- oder Display-Auslösung um und erhöhen Sie die TTS-Wiedergabegeschwindigkeit auf 1,15x, damit die Sprachausgabe beendet ist, bevor Ihr Gegenüber ansetzt. Wenn kein Mobilfunkempfang verfügbar ist, zeigt unsere Übersicht zu Offline-Übersetzungs-Ohrhörern, wie lokale NPU-Sprachpakete arbeiten.
Häufig gestellte Fragen
Warum erscheint der übersetzte Text auf dem Handy früher als der Ton im Ohrhörer?
Streaming-ASR zeigt vorläufige Worthypothesen schon während des Sprechens an. Das neuronale Übersetzungsmodell und die Sprachsynthese müssen jedoch das Ende des grammatikalischen Satzes abwarten, um Verben sinnvoll umzustellen und eine natürliche Sprachmelodie zu erzeugen, bevor die Audiodatei an die Ohrhörer gestreamt wird.
Beseitigt Bluetooth 5.3 oder 5.4 die Verzögerung bei Übersetzungs-Ohrhörern?
Neuere Bluetooth-Standards verbessern die Verbindungsstabilität und senken den Energiebedarf, sparen auf der Funkübertragungsstrecke aber nur wenige Dutzend Millisekunden ein; der größte Teil der Verzögerung geht auf das Warten auf Satzgrenzen und die VAD-Pausenzeit zurück.