

Слушалки за превод в реално време и латентност при разпознаване на паузи от ASR в жив разговор
Маркетинговите демонстрации на слушалките за превод в реално време често внушават мигновен дублаж, но всеки, който ги изпробва на шумна гара в Токио или изложбен щанд в Милано, забелязва пауза от 2 до 4 секунди преди преведеният глас да прозвучи в ухото. Това забавяне рядко се дължи на бавна Bluetooth връзка или тромави облачни сървъри; основното тясно място е езиковото и акустичното разпознаване на границите на фразата в ядрото за автоматично гласово разпознаване (ASR).
Преди моделът за невронен машинен превод да може да преобразува изречение между езици с противоположен словоред — като японски (подлог–допълнение–сказуемо) към английски (подлог–сказуемо–допълнение), — детекторът за гласова активност (VAD) трябва да потвърди, че говорещият е завършил граматичната фраза. Твърде късият праг на тишина нарязва естествените колебания в накъсани парчета, а твърде дългият бави живия диалог.
Разбор на цялостната латентност в конвейера за синхронен превод
Всяко изказване, уловено от микрофонния масив с насочено приемане (beamforming), преминава през пет последователни етапа: кадриране на входящия Bluetooth SCO/LE Audio поток, времеви прозорец за тишина на VAD, поточна генерация на токени от ASR, контекстно пренареждане на невронния машинен превод (NMT) и вокодерен синтез на реч (TTS). Докато мрежовото двупосочно време през 5G или Wi-Fi е средно между 80 и 180 ms, таймерът за край на изречението на VAD съзнателно изчаква 500 до 1200 ms акустична тишина, за да отчете границата на мисълта.
Езиците със сказуемо накрая задължават буфера за превод да задържа токените, докато не се произнесе глаголът в самия край на фразата. Дори когато стрийминг ASR изписва думите на екрана на смартфона ви в рамките на 300 ms, аудиомодулът на TTS задържа гласовото възпроизвеждане, докато синтактичната подредба не приключи, за да не се налага изкуственият глас да се връща назад по средата на изречението.
| Етап от конвейера | Типичен времеви бюджет (ms) | Контролиращ компонент | Ефект от агресивно съкращаване | Стратегия за оптимизация |
|---|---|---|---|---|
| Bluetooth микрофонна връзка | 40 – 90 ms | SoC на слушалката и стек на хоста | Загуба на пакети в натоварен 2,4 GHz диапазон | Дръжте телефона на под 50 см от незакритата страна |
| VAD праг на тишина (край) | 500 – 1 200 ms | Аудио енджин на придружаващото приложение | Прекъсва паузите на говорещия и разцепва фрази | Използвайте ръчно задействане с докосване (Touch) |
| Поточно ASR декодиране | 180 – 350 ms | Облак или вграден NPU на телефона | По-висок процент грешки при собствени имена | Изберете предварително профил за област или диалект |
| NMT превод и TTS синтез | 350 – 830 ms | Модел за превод и вокодер | Роботизирана интонация и накъсана реч | Говорете на кратки самостоятелни фрази; скорост TTS 1.15x |
Как режимите на разговор управляват времето на засичане на ASR
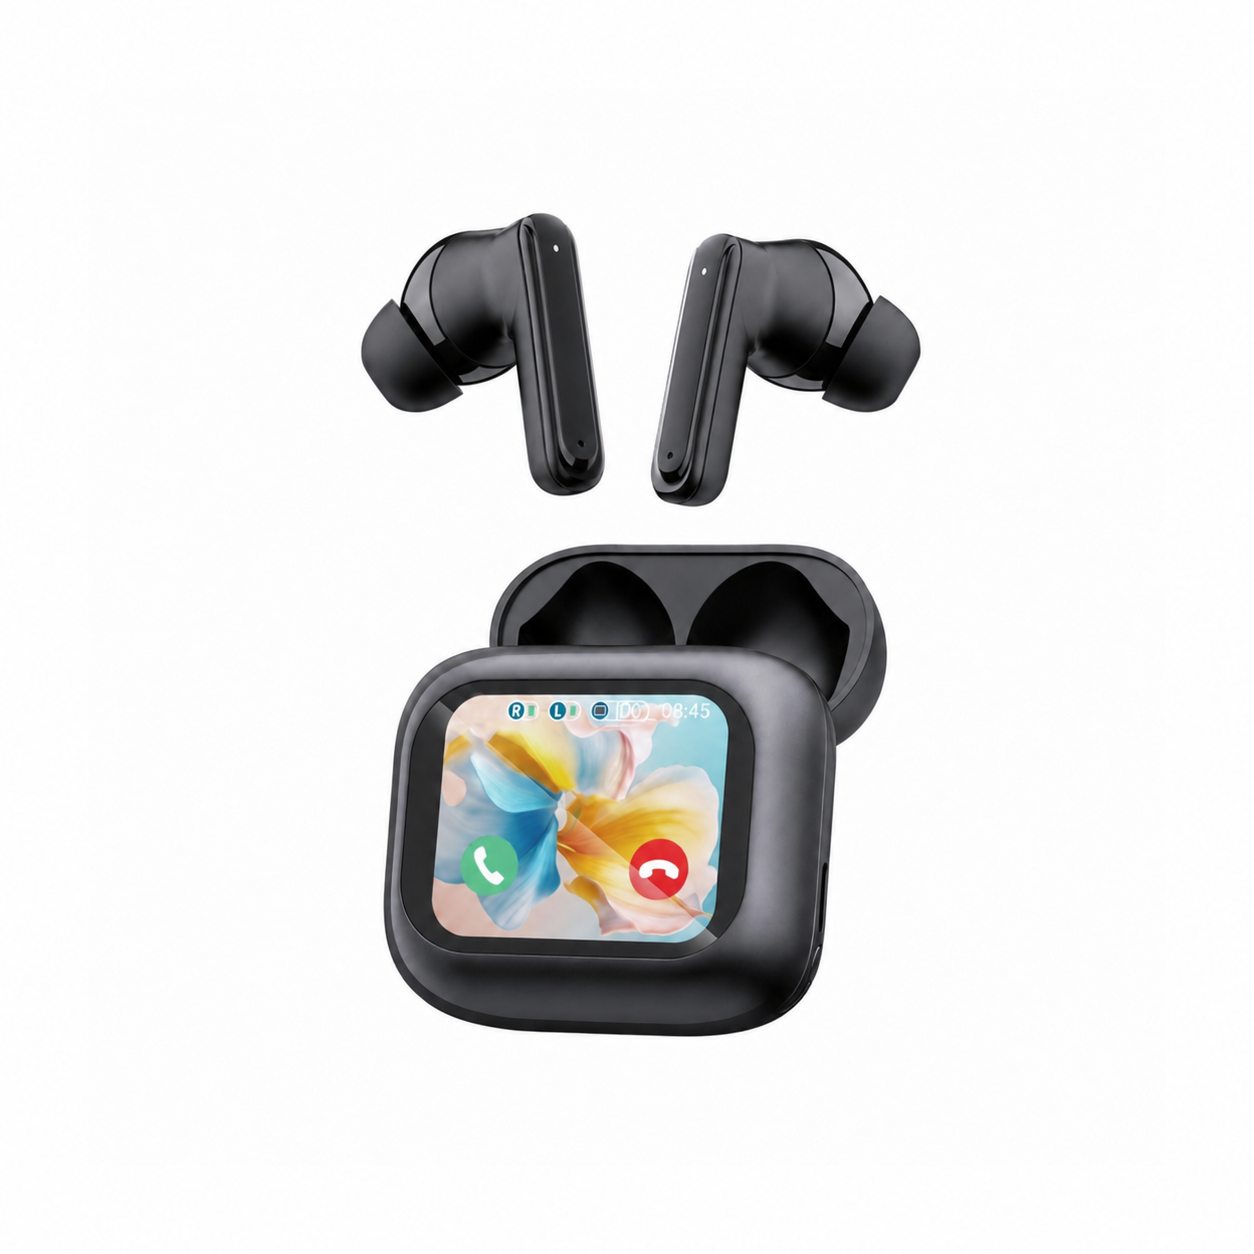
Тъй като автоматичното откриване на паузи се затруднява в отекли помещения, където шумът от чаши в кафене наподобява гласова енергия, приложенията предлагат отделни режими на комуникация. При сензорния режим (Touch Mode / Press-to-Talk) докосването и пускането на стеблото на слушалката затваря аудио буфера ръчно, премахвайки 800-милисекундния прозорец за чакане на VAD и сваляйки общото забавяне под 1,2 секунди.
Режимите за свободен разговор (Free-Talk) и симултанно слушане разчитат изцяло на енергийните прагове на алгоритъма VAD и микрофонното насочване за изолиране на гласовете. За да върви преводът гладко по време на по-дълги лекции или обстойни обяснения, правете чиста пауза от един цял такт между отделните мисли, вместо да ги свързвате с паразитни думи като „ъ-ъ“ или „така че“.
Почивка за ушите след часове със синтезиран TTS звук
Слушането на компресиран синтезиран глас, докато едновременно следите събеседник на чужд език, създава голямо когнитивно натоварване и постоянен акустичен натиск в средните честоти върху вътрешното ухо. Когато се приберете в хотела след цял ден международни срещи, стандартните стърчащи слушалки създават напрежение и неудобство при опит да легнете на възглавницата.
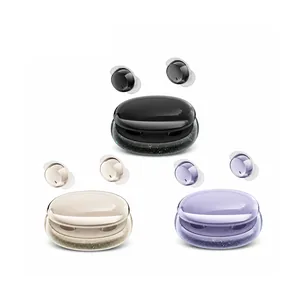
Flat, stemless earbuds for sleeping on your side, with a dynamic sleep-support mode and a starlight glow charging case. See the three colors at EARSOLE.
Замяната на дневните слушалки за AI превод с ултратънки капсули за сън позволява на ушната мида и канала да се отпуснат без страничен натиск. Вместо остри гласови честоти, деликатните успокояващи амбиентни звуци прикриват стъпките по коридора и възстановяват слуха през нощта.
Практически навици при говорене, които намаляват забавянето наполовина
Можете да спестите почти цяла секунда от всяка разменена реплика, като промените начина на изразяване и дистанцията до микрофона. Говорете с ясни съобщителни изречения от 10 до 15 думи с отчетлива точка в края и избягвайте незавършени съюзи, които карат буфера на ASR да продължава да чака следващо подчинено изречение.
В шумна среда над 70 dBA преминете от автоматичен VAD към ръчно освобождаване чрез докосване или екран и увеличете скоростта на възпроизвеждане на TTS на 1.15x, за да приключва преводът преди събеседникът ви да е заговорил отново. Ако изобщо нямате мобилен интернет, разгледайте нашия инженерен преглед на слушалки за офлайн превод и локални езикови пакети за NPU.
Често задавани въпроси
Защо преведеният текст се появява на екрана на телефона секунда преди да чуя гласа в слушалките?
Стрийминг ASR изписва предполагаемите думи в реално време, докато говорите, но модулите за невронен превод и гласов синтез трябва да изчакат завършването на граматичната фраза, за да пренаредят глаголите и да генерират естествена интонация преди изпращането на звука към слушалките.
Премахва ли Bluetooth 5.3 или 5.4 забавянето при слушалките за синхронен превод?
По-новите версии на Bluetooth осигуряват по-добра стабилност на връзката и енергийна ефективност, но съкращават само няколко десетки милисекунди на ниво безжичен пренос; основната част от забавянето идва от езиковото буфериране на изреченията и таймерите за тишина на VAD.