

Fones de Tradução em Tempo Real e a Latência de Pausa do ASR em Conversas ao Vivo
Demonstrações comerciais de fones de tradução em tempo real costumam sugerir uma dublagem instantânea, mas qualquer pessoa que os utilize em uma estação barulhenta de Tóquio ou em um estande de feira em Milão percebe um intervalo nítido de dois a quatro segundos antes que o áudio traduzido chegue aos ouvidos. Esse atraso raramente decorre de transmissão Bluetooth lenta ou de servidores lentos em nuvem; o gargalo principal está na detecção de fronteiras linguísticas e acústicas dentro do motor de Reconhecimento Automático de Fala (ASR).
Antes que um modelo neural de tradução automática consiga converter uma frase falada entre idiomas com ordens sintáticas opostas — como o japonês (Sujeito-Objeto-Verbo) para o inglês ou português (Sujeito-Verbo-Objeto) —, o Detector de Atividade Vocal (VAD) precisa confirmar que o interlocutor concluiu a oração gramatical. Ajustar esse limite de silêncio de final de frase para um valor muito curto fragmenta hesitações naturais em cortes confusos, enquanto configurá-lo para um valor longo demais trava o ritmo natural da conversa.
Decompondo o Pipeline de Latência Ponta a Ponta na Tradução ao Vivo
Cada enunciado captado pelo arranjo beamforming dos fones passa por cinco etapas consecutivas: empacotamento no uplink Bluetooth SCO/LE Audio, janela de silêncio do VAD, geração de tokens no ASR em streaming, reordenação de contexto na Tradução Automática Neural (NMT) e síntese vocoder de Texto para Fala (TTS). Embora o tempo de ida e volta da rede em 5G ou Wi-Fi fique em média entre 80 e 180 milissegundos, o temporizador de término do VAD aguarda deliberadamente de 500 a 1.200 milissegundos de silêncio acústico para marcar o fim de uma frase.
Idiomas com sintaxe de verbo no final forçam o buffer de tradução a reter os tokens até que o predicado apareça no encerramento da oração. Mesmo quando o ASR contínuo transcreve as palavras na tela do smartphone em menos de 300 milissegundos, o motor de áudio TTS retém a reprodução vocal até que a reordenação sintática esteja concluída, evitando que a voz sintetizada precise voltar atrás no meio da frase.
| Estágio do Pipeline | Orçamento Típico de Tempo (ms) | Componente de Controle | Impacto do Encurtamento Excessivo | Estratégia de Otimização |
|---|---|---|---|---|
| Uplink de Microfone Bluetooth | 40 – 90 ms | SoC do Fone e Stack do Host | Perda de pacotes em locais lotados na faixa de 2,4 GHz | Manter o celular a até 50 cm no lado desobstruído |
| Silêncio de Término do VAD | 500 – 1.200 ms | Motor de Áudio do Aplicativo | Corta pausas do locutor e divide orações | Usar liberação manual de fronteira por toque |
| Decodificação ASR Streaming | 180 – 350 ms | NPU Local ou Nuvem | Maior taxa de erro em homófonos e nomes próprios | Pré-selecionar o perfil do domínio ou dialeto regional |
| Síntese NMT e TTS | 350 – 830 ms | Modelo de Tradução e Vocoder | Prosódia robótica e consoantes truncadas | Falar em frases curtas; ajustar TTS para 1,15x |
Como os Modos de Conversa Controlam a Temporização do ASR
Como a detecção automática de pausas perde precisão em ambientes com reverberação onde o ruído de fundo imita a energia da voz humana, os aplicativos dividem a tradução em modos específicos de interação. No Modo Toque (ou Press-to-Talk), pressionar e soltar a haste do fone encerra manualmente o buffer de áudio, eliminando a janela de espera de 800 milissegundos do VAD e reduzindo a latência total para menos de 1,2 segundo.
Já os modos Fala Livre e Escuta Simultânea dependem inteiramente de limiares algorítmicos de energia do VAD e de microfones direcionais para isolar vozes. Para manter o fluxo contínuo da tradução em apresentações longas ou explicações complexas, quem fala deve fazer pausas limpas de um tempo completo entre ideias concluídas, evitando emendar orações com termos de preenchimento como “ééé” ou “então assim”.
Descansando os Ouvidos Após Horas de Áudio Sintetizado por TTS
Ouvir vozes comprimidas de sintetizadores de fala enquanto se acompanha atentamente um interlocutor em outro idioma impõe uma carga cognitiva pesada e pressão acústica constante nas frequências médias. Ao voltar para o quarto de hotel após um dia inteiro de reuniões multilíngues, os fones tradicionais salientes incomodam e pressionam o canal auditivo contra o travesseiro.
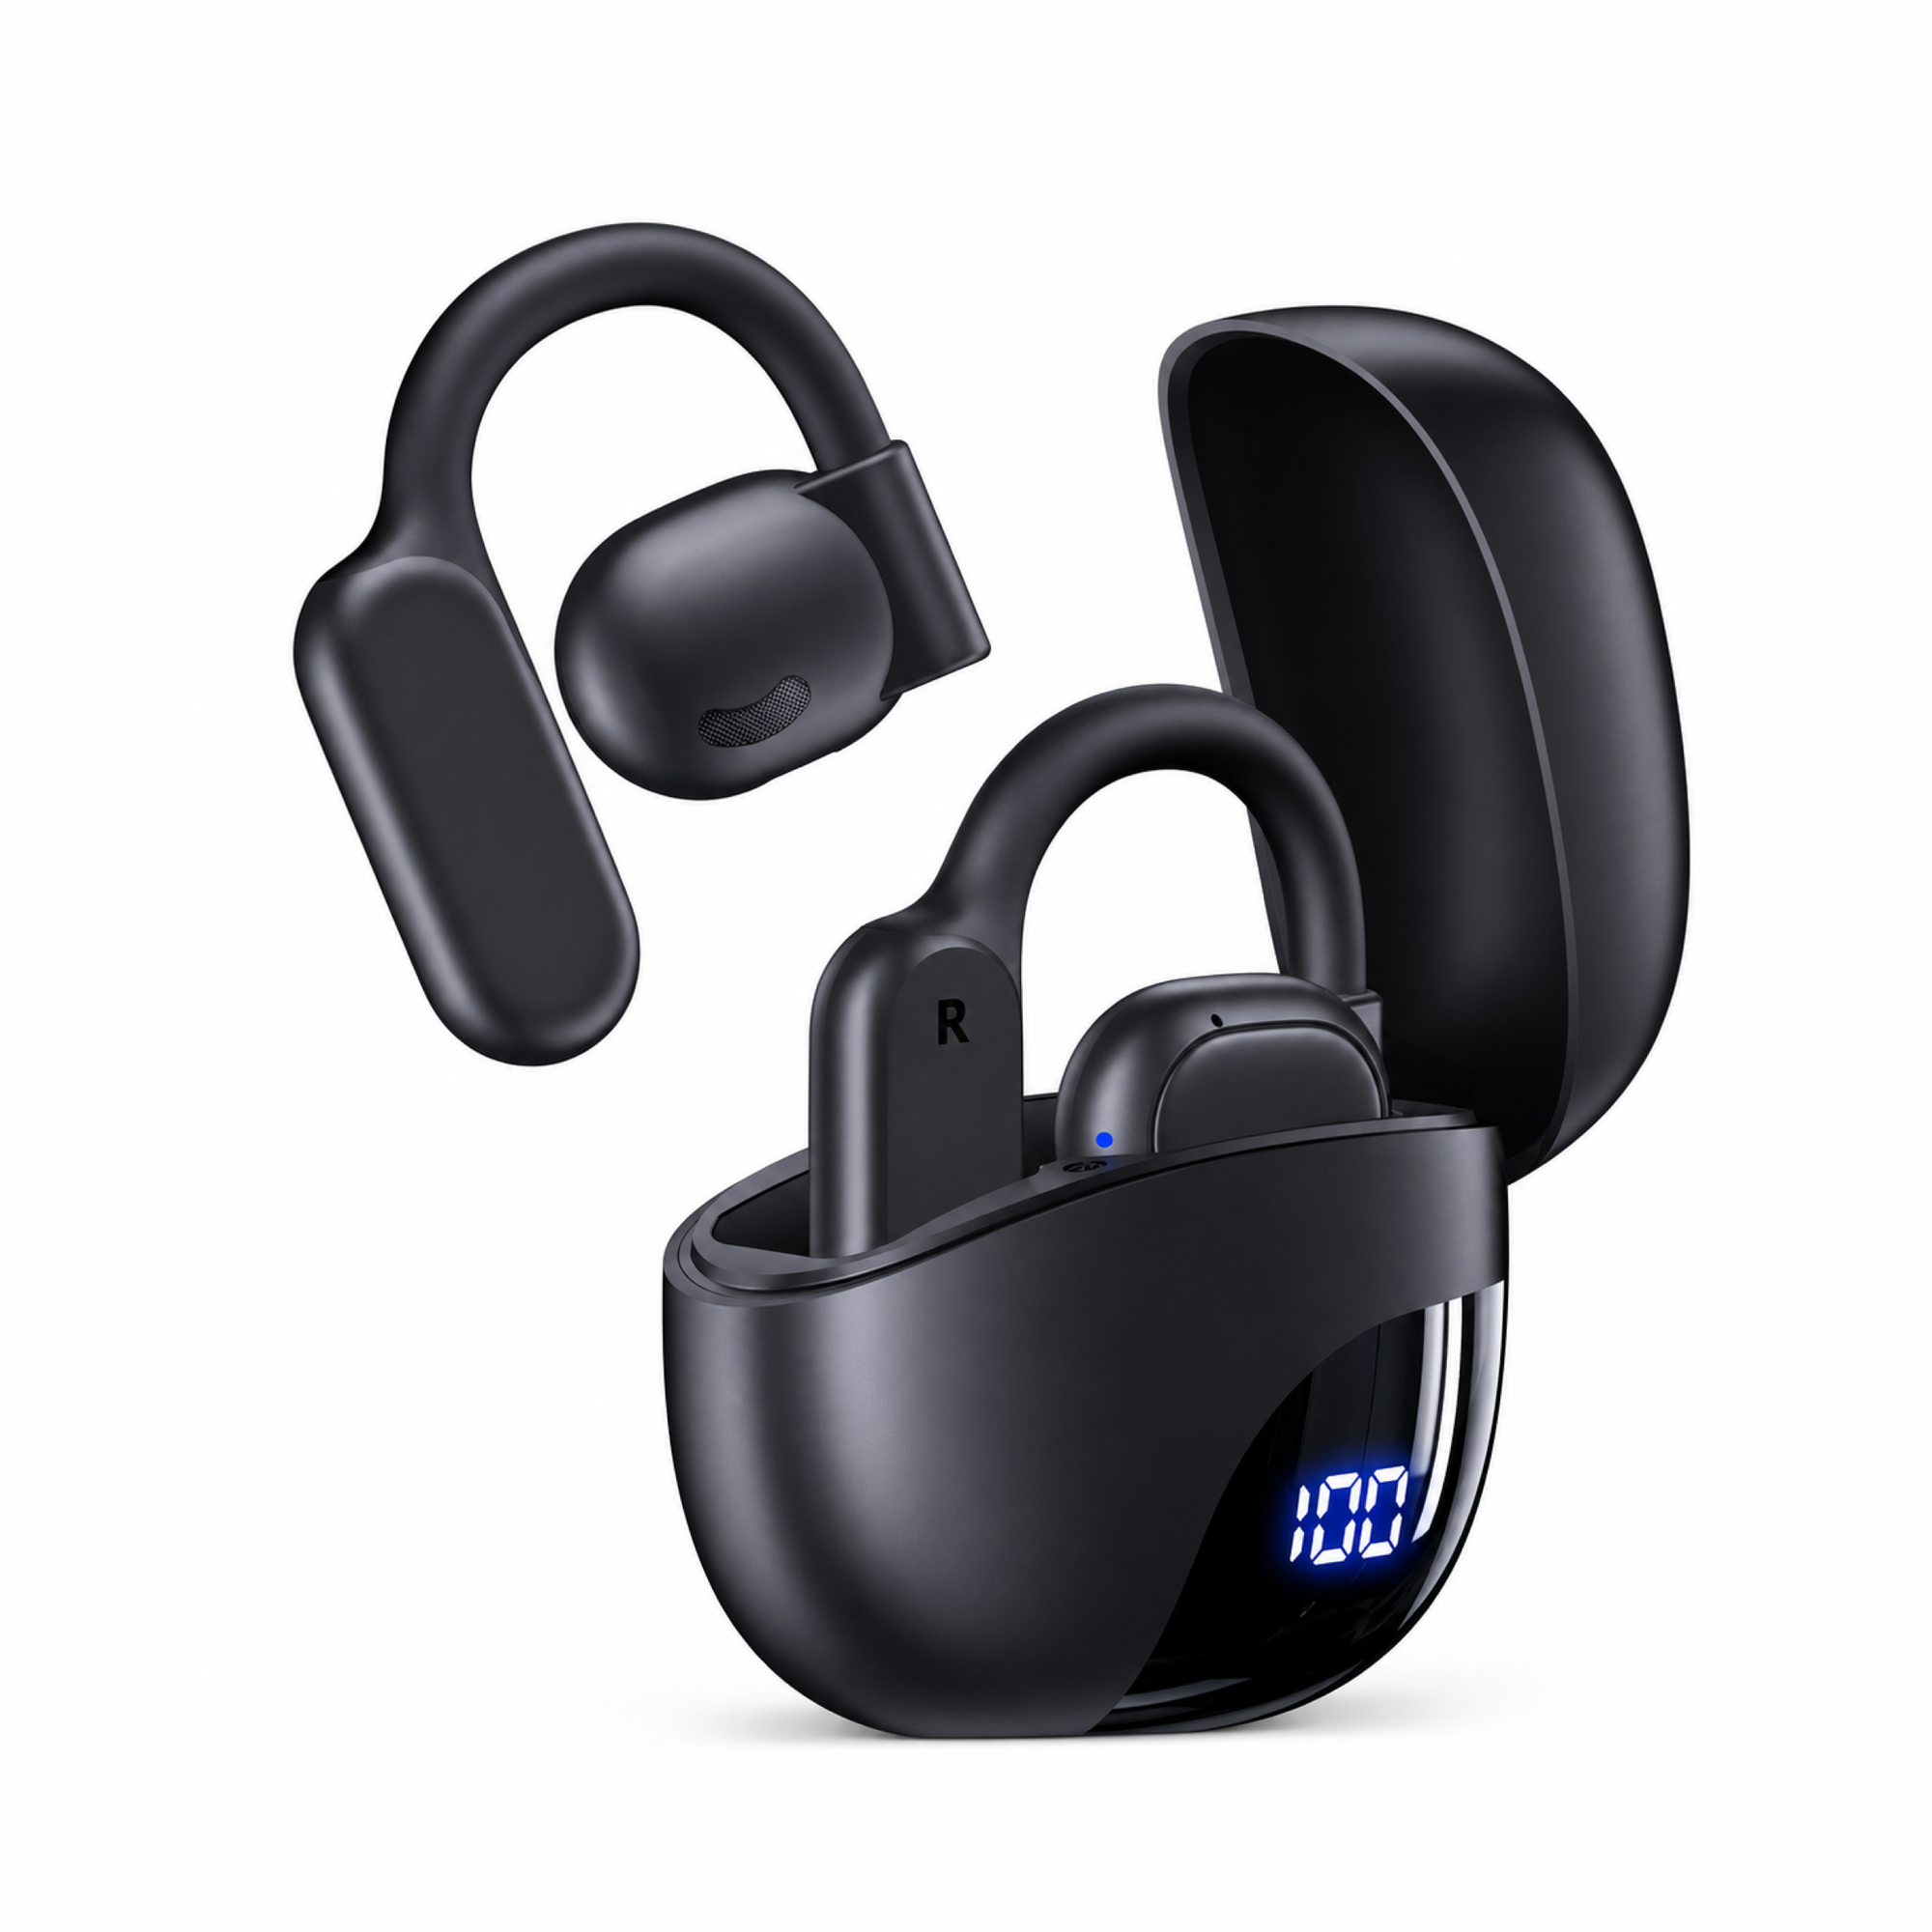
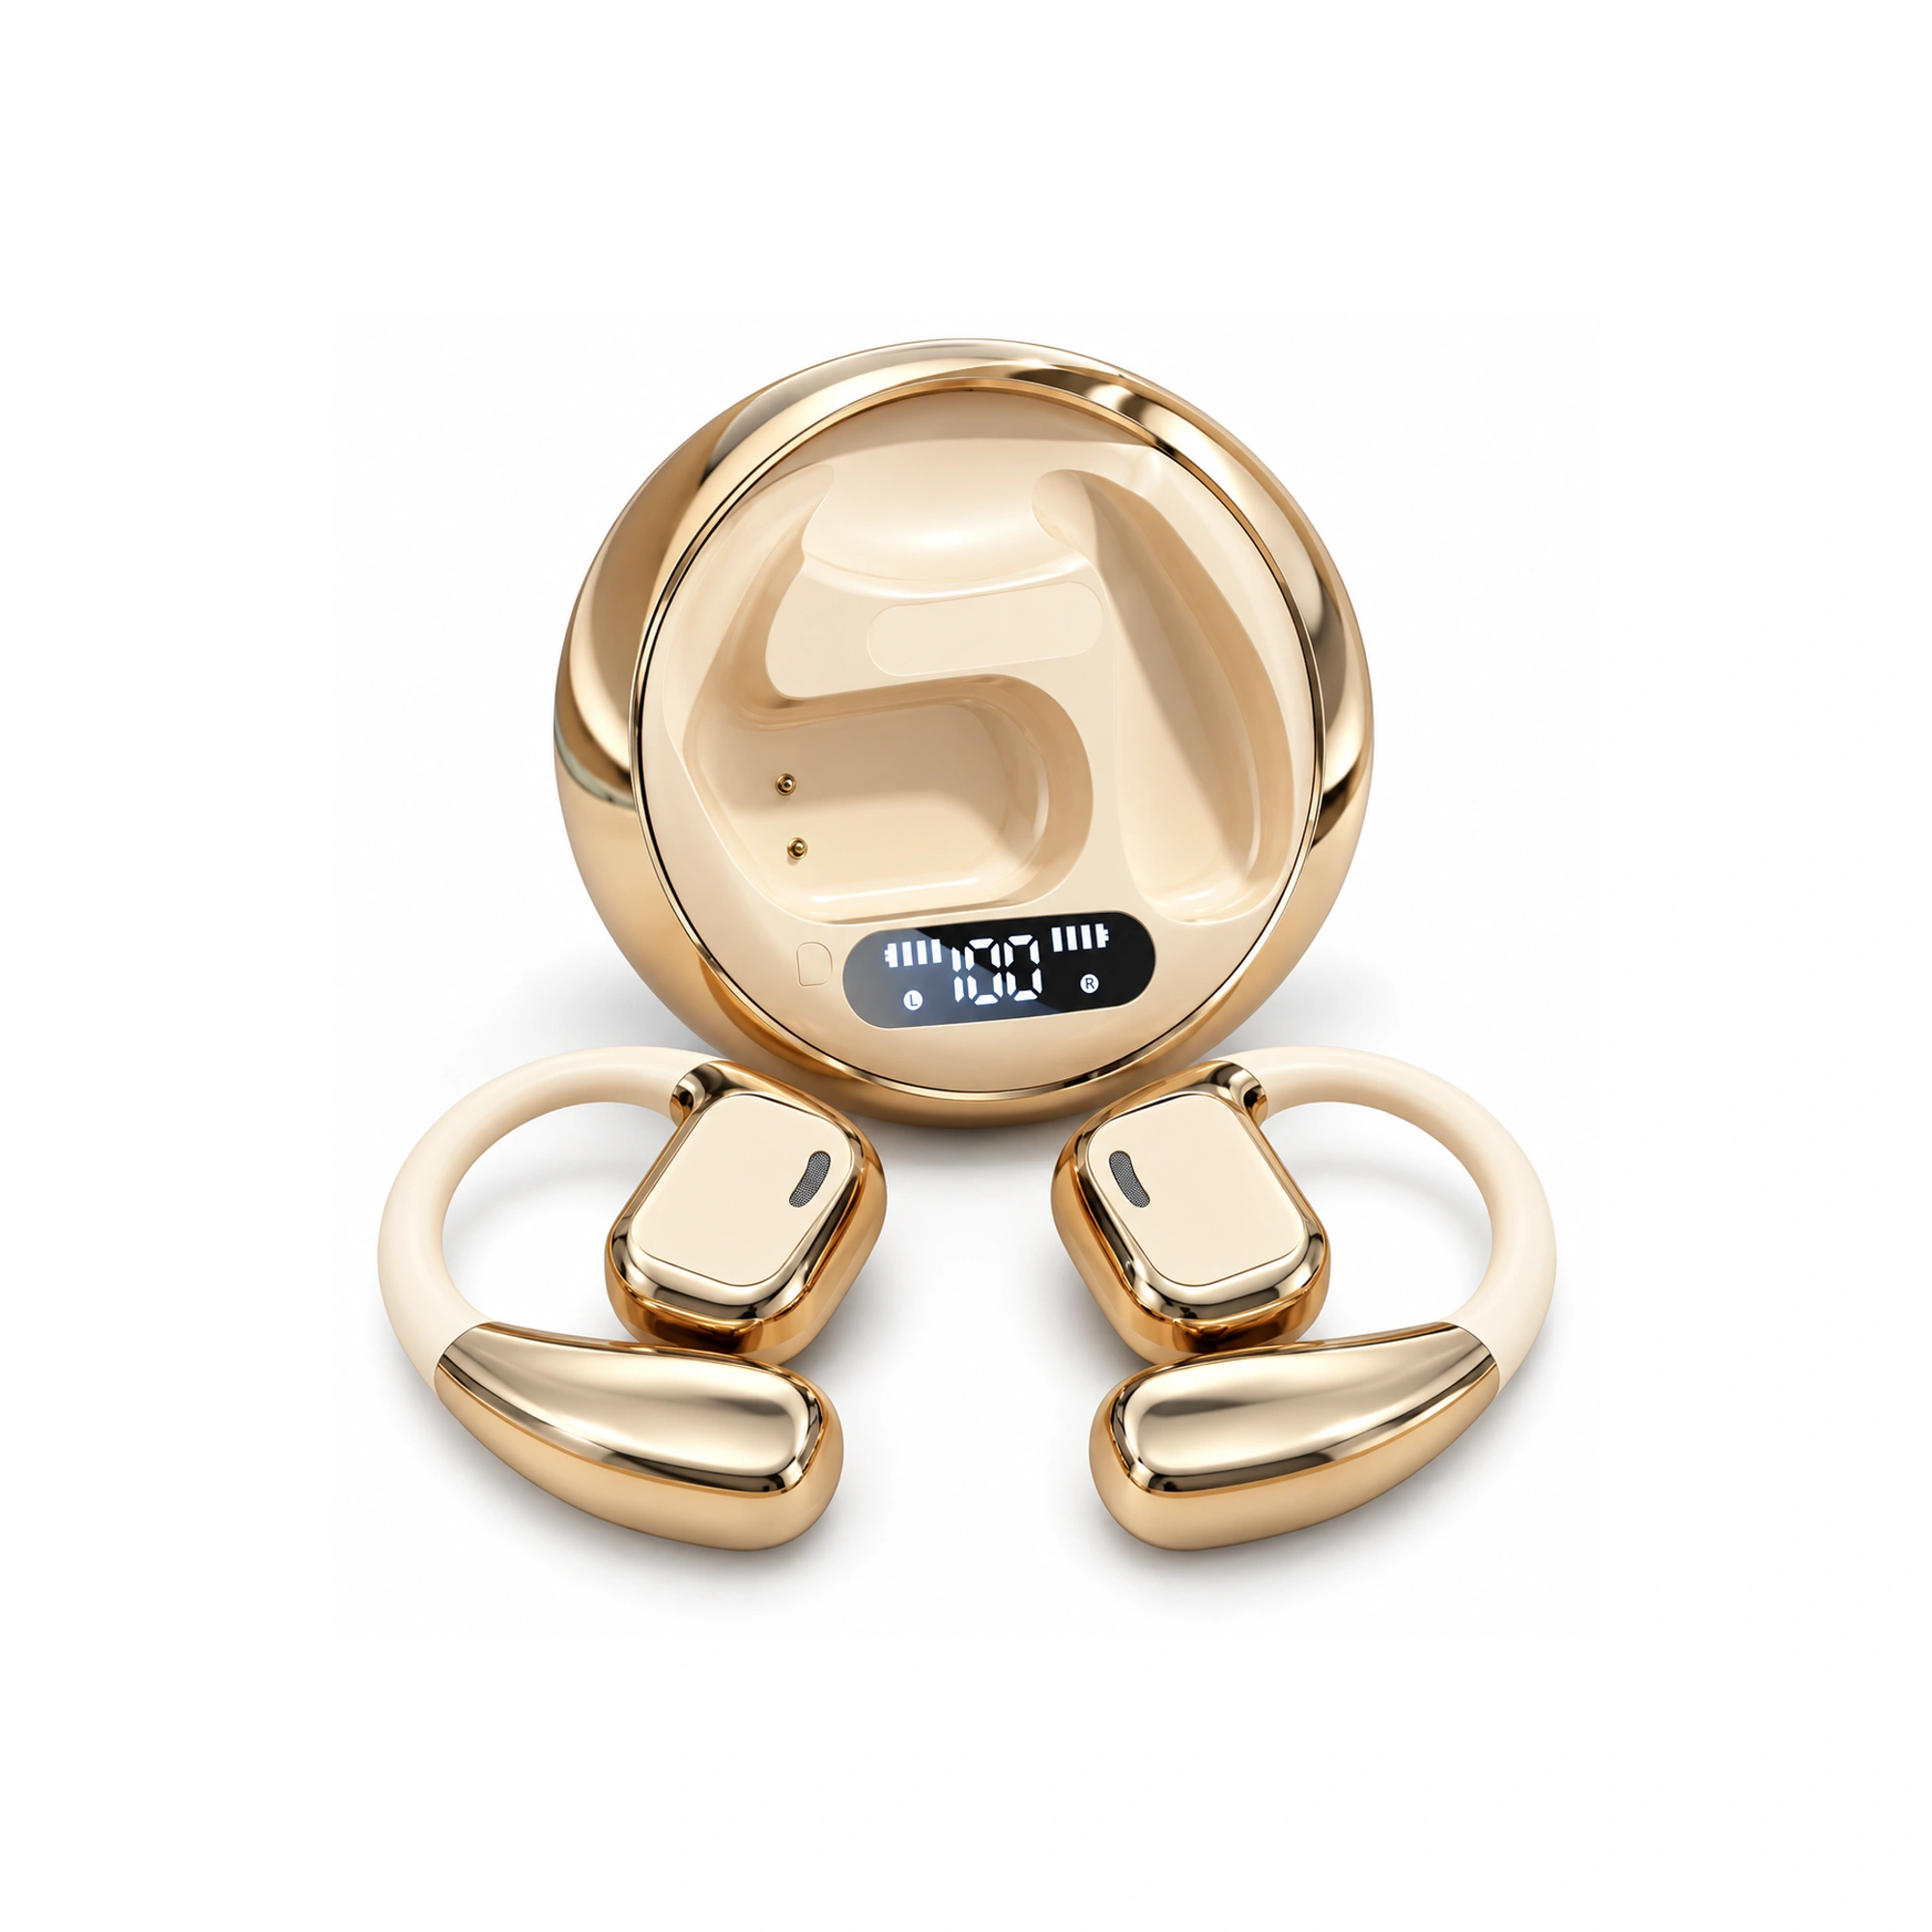
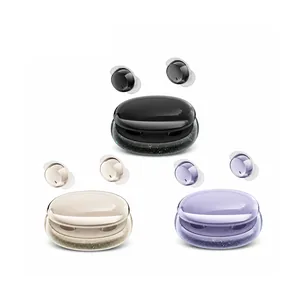
Flat, stemless earbuds for sleeping on your side, with a dynamic sleep-support mode and a starlight glow charging case. See the three colors at EARSOLE.
Trocar os fones de ouvido com tradução por IA diurnos por um modelo de perfil ultrafino para dormir permite que o pavilhão auricular e o canal auditivo descomprimam sem atrito lateral. Em vez de frequências vocais estridentes, paisagens sonoras suaves atenuam passos nos corredores e ajudam a recuperar a audição durante a noite.
Hábitos Práticos de Fala que Reduzem o Atraso da Tradução pela Metade
É possível reduzir quase um segundo inteiro em cada interação ajustando o modo de formular frases e controlando a distância do microfone. Fale em frases declarativas de dez a quinze palavras com uma pausa firme ao final de cada uma, evitando conjunções suspensas que induzem o buffer preditivo do ASR a continuar aguardando mais termos.
Em ambientes com ruído acima de 70 dBA, substitua a detecção automática do VAD pelo acionamento manual no fone ou na tela e aumente a velocidade do TTS para 1,15x, garantindo que o áudio traduzido termine antes de o parceiro de conversa iniciar a próxima fala. Em cenários sem roaming celular disponível, confira nossa análise técnica sobre fones de tradução offline e pacotes neurais locais para NPU.
Perguntas Frequentes
Por que o texto traduzido aparece na tela do celular antes de eu ouvir a voz nos fones?
O ASR contínuo projeta hipóteses parciais de palavras conforme você fala, mas os motores de tradução neural e síntese de voz precisam esperar a conclusão da oração para reorganizar verbos e gerar curvas naturais de entonação antes de transmitir o áudio aos fones.
O Bluetooth 5.3 ou 5.4 elimina o atraso nos fones de tradução em tempo real?
As versões mais recentes do Bluetooth aprimoram a estabilidade da conexão e a eficiência energética, mas reduzem apenas algumas dezenas de milissegundos na camada sem fio; a maior parte da latência provém do buffer de orações gramaticais e dos temporizadores de pausa do VAD.